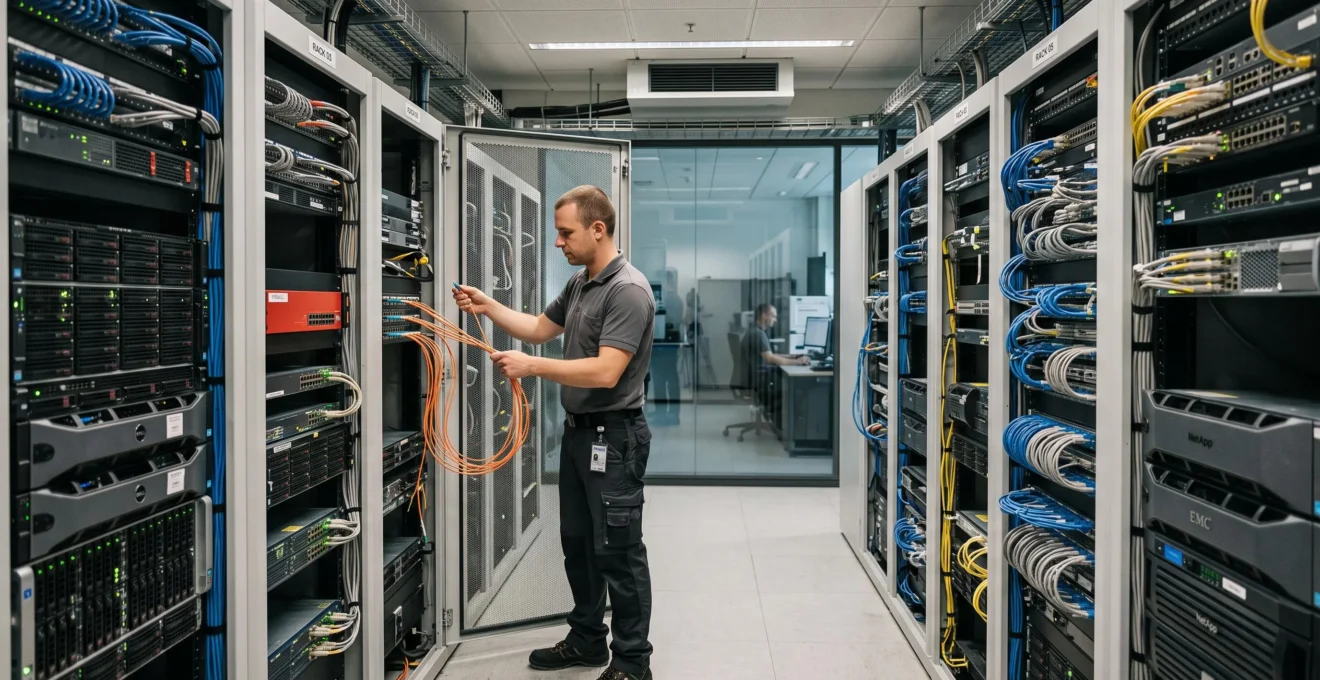
Eine hybride IT-Infrastruktur entsteht, wenn Unternehmen lokale Systeme und Cloud-Dienste gezielt miteinander verbinden, statt sämtliche Anwendungen und Daten an einen einzigen Betriebsort zu verlagern. Entscheidend ist dabei nicht die Anzahl der eingesetzten Technologien, sondern die kontrollierte Zusammenarbeit zwischen beiden Umgebungen. Geschäftskritische Daten können beispielsweise im Schweizer Rechenzentrum verbleiben, während skalierbare Anwendungen oder Entwicklungsumgebungen Cloud-Ressourcen nutzen.
Für eine belastbare Architektur müssen Identitäten, Netzwerkverbindungen, Datenflüsse, Sicherheitsrichtlinien und Betriebsprozesse gemeinsam geplant werden. Besonders relevant sind die Anforderungen des Schweizer Datenschutzgesetzes (DSG), technische Abhängigkeiten von Legacy-Systemen und die tatsächlichen Latenzanforderungen der Anwendungen. Auch Unternehmen mit Standorten in Deutschland sollten ihre jeweiligen datenschutzrechtlichen und branchenspezifischen Verpflichtungen berücksichtigen.
Der pragmatische Ansatz besteht darin, zunächst die Workloads zu klassifizieren, anschliessend eine gemeinsame Architektur zu definieren und die Migration schrittweise anhand messbarer Kriterien umzusetzen. So lassen sich Cloud-Flexibilität und lokale Kontrolle verbinden, ohne neue Sicherheitslücken oder schwer beherrschbare Betriebsabhängigkeiten zu schaffen.
Hybride IT-Infrastruktur: Das Wichtigste im Überblick
- Eine gemeinsame Identitäts-, Sicherheits- und Integrationsarchitektur verhindert widersprüchliche Berechtigungen zwischen lokalen Systemen und Cloud-Diensten.
- Datenstandort, Netzwerkleistung, Abhängigkeiten und Betriebskosten bestimmen, welche Workloads in die Cloud gehören und welche lokal bleiben sollten.
- Ein schrittweiser Einstieg mit geeigneten Pilot-Workloads, getesteten Wiederherstellungsverfahren und klaren Verfügbarkeitszielen reduziert Migrationsrisiken.
- Warum hybride IT-Infrastrukturen scheitern, wenn Identitäten doppelt verwaltet werden?
- Wie planen Sie Ihre hybride IT-Infrastruktur anhand von 5 zentralen Bausteinen?
- VPN oder direkte Verbindung: Welche Netzwerkanbindung eignet sich für stabile Workloads und sensible Daten?
- Der Hybrid-Fehler, der durch unkontrollierte Datenübertragungen unerwartet hohe Cloud-Rechnungen verursacht
- Welche 3 Workloads sollten zuerst hybrid werden, damit das Migrationsrisiko gering bleibt?
- Wie definieren Sie 5 Integrationsstandards, damit neue Tools nahtlos in Ihre hybride IT-Infrastruktur eingebunden werden?
- Wie planen Sie die Serverkapazität anhand von 6 Messwerten statt nach Bauchgefühl?
- Wie dimensionieren Sie Ihre Serverinfrastruktur, wenn eine Verfügbarkeit von 99,9 % gefordert ist?
Warum hybride IT-Infrastrukturen scheitern, wenn Identitäten doppelt verwaltet werden?
Hybride IT-Infrastrukturen scheitern häufig an uneinheitlichen Identitäts- und Berechtigungsmodellen. Eine zentrale Anmeldung für lokale Anwendungen und Cloud-Dienste reicht nicht aus, wenn Zugriffsrechte unabhängig voneinander vergeben und widerrufen werden. Erfolgreiche hybride Identitätsverwaltung benötigt deshalb einen führenden Identity Provider, konsistente Autorisierungsregeln und klar getrennte Lebenszyklen für Benutzer- und technische Konten.
Entscheidend ist die Unterscheidung zwischen Authentifizierung und Autorisierung. Die Authentifizierung überprüft, ob eine Person oder ein Gerät tatsächlich die behauptete Identität besitzt. Die Autorisierung entscheidet anschliessend, welche Ressourcen diese Identität verwenden darf. Microsoft dokumentiert diese Trennung ausdrücklich in seiner technischen Beschreibung der Identitätsplattform.
Ein föderiertes Identitätsmodell ermöglicht, dass sich Mitarbeitende über einen zentralen Identity Provider bei verschiedenen Anwendungen anmelden. Standards wie SAML 2.0 und OpenID Connect unterstützen diese Zusammenarbeit. Während SAML häufig in Unternehmensumgebungen eingesetzt wird, ist OpenID Connect insbesondere bei modernen Cloud-Anwendungen verbreitet.
Ein hypothetisches Beispiel verdeutlicht das Risiko: Ein Mitarbeiter verlässt das Unternehmen. Sein lokales Benutzerkonto wird deaktiviert, die SaaS-Anwendung verwaltet jedoch weiterhin ein eigenständiges Benutzerkonto mit gültigen Berechtigungen. Die lokale Deaktivierung beendet in diesem Fall nicht automatisch sämtliche externen Zugriffe. Erst eine koordinierte Deprovisionierung über alle angebundenen Anwendungen verhindert solche verwaisten Berechtigungen.
Das Berechtigungsmodell sollte deshalb festlegen, welches System für Benutzerattribute, Gruppen, Rollen und privilegierte Zugänge verantwortlich ist. Menschliche Benutzer, Servicekonten und technische Identitäten benötigen unterschiedliche Prozesse für Erstellung, Rotation, Überwachung und Deaktivierung. Besonders privilegierte Konten sollten nach dem Least-Privilege-Prinzip nur die tatsächlich notwendigen Rechte erhalten.
Eine weitere Schwachstelle ist die Abhängigkeit vom zentralen Identity Provider. Wird dieser durch einen technischen Fehler oder eine Netzwerkstörung unerreichbar, können Cloud-Anmeldungen und administrative Zugänge ausfallen. Lokale Anwendungen können ebenfalls betroffen sein, wenn ihre Authentifizierung vollständig von diesem Dienst abhängt.
Für solche Szenarien sind unabhängige Notfallzugänge erforderlich. Microsoft empfiehlt für Microsoft Entra ID mindestens zwei Notfallkonten und weist darauf hin, dass Notfallzugänge für lokale Systeme und Cloud-Dienste voneinander unabhängig gestaltet werden sollten. Diese Empfehlung ist eine produktspezifische Sicherheitsmassnahme, keine allgemeingültige gesetzliche Vorgabe.
Die Microsoft-Dokumentation zu Authentifizierung und Autorisierung erläutert die technischen Grundlagen und die Rolle föderierter Identitätsdienste.
Ein belastbares Notfallkonzept umfasst ausserdem alternative Authentifizierungswege, geschützte administrative Konten, dokumentierte Wiederherstellungsprozesse und regelmässige Funktionstests. Dabei muss überprüft werden, ob die Zugänge tatsächlich unabhängig vom ausgefallenen Identitätsdienst funktionieren.
Erst wenn Benutzer, Anwendungen und administrative Konten über nachvollziehbare Zuständigkeiten verfügen, lässt sich die hybride Infrastruktur zuverlässig erweitern. Darauf aufbauend folgt die Planung der fünf zentralen Architekturbausteine.
Wie planen Sie Ihre hybride IT-Infrastruktur anhand von 5 zentralen Bausteinen?
Eine hybride IT-Infrastruktur lässt sich anhand von fünf miteinander verbundenen Architekturbausteinen planen: Infrastruktur und Compute, Daten und Storage, Netzwerk und Konnektivität, Identität und Sicherheit sowie Integration und Betrieb. Diese Struktur verhindert, dass Unternehmen lediglich Cloud-Dienste und lokale Server verbinden, ohne deren technische und organisatorische Abhängigkeiten zu berücksichtigen.
Der erste Baustein ist die Infrastruktur. Hier wird festgelegt, welche Anwendungen auf lokalen Servern, virtuellen Maschinen, Containern oder Cloud-Plattformen laufen. Massgeblich sind Skalierungsbedarf, Hardwareabhängigkeiten, Lizenzierung und technische Anforderungen der jeweiligen Anwendung.
Der zweite Baustein betrifft Daten und Storage. Unternehmen sollten festlegen, welche Daten lokal gespeichert werden, welche Cloud-Dienste verwenden dürfen und wo Replikationen oder Backups erforderlich sind. Dabei sind Schutzbedarf, Wiederherstellbarkeit und mögliche internationale Datenübermittlungen zu berücksichtigen.
Für Schweizer Unternehmen ist das revidierte Datenschutzgesetz (revDSG) besonders relevant, wenn Personendaten durch externe Cloud-Anbieter bearbeitet werden. Der EDÖB stellt klar, dass das verantwortliche Unternehmen für die datenschutzkonforme Bearbeitung durch den Cloud-Anbieter verantwortlich bleibt. Vor einer Auslagerung müssen deshalb insbesondere Sicherheitsmassnahmen, Unterauftragsbearbeiter und mögliche Auslandübermittlungen geprüft werden.
Die EDÖB-Informationen zum Cloud-Computing erläutern die Verantwortlichkeiten und wesentlichen Prüfbereiche bei der Nutzung externer Cloud-Dienste.
Der dritte Baustein ist das Netzwerk. Verbindungen zwischen lokalen Anwendungen und Cloud-Ressourcen müssen hinsichtlich Bandbreite, Latenz, Redundanz und Sicherheitskontrollen dimensioniert werden. Auch DNS, Routing und Firewall-Regeln gehören zur Planung.
Der vierte Baustein umfasst Identität und Sicherheit. Dazu zählen zentrale Authentifizierung, Rollenmodelle, privilegierte Zugriffe, Verschlüsselung und die Überwachung sicherheitsrelevanter Ereignisse.
Der fünfte Baustein betrifft Integration und Betrieb. Anwendungen benötigen definierte Schnittstellen, nachvollziehbare Datenverträge und gemeinsame Betriebsprozesse. Dazu gehören Monitoring, Patchmanagement, Backup, Incident Response und Kostenkontrolle.
Eine zentrale Planungsgrundlage ist die Workload- und Datenklassifizierung. Jede Anwendung sollte anhand folgender Kriterien bewertet werden:
- Schutzbedarf: Welche Vertraulichkeits- und Integritätsanforderungen bestehen?
- Datenstandort: Wo dürfen die Daten gespeichert und verarbeitet werden?
- Latenz: Welche Antwortzeiten benötigen Benutzer und verbundene Systeme?
- Abhängigkeiten: Welche Datenbanken, Schnittstellen und Identitätsdienste sind erforderlich?
- Skalierung: Wie stark schwankt der Ressourcenbedarf?
- Wiederherstellung: Welche Ausfallzeiten und Datenverluste sind akzeptabel?
Eine Abhängigkeitsmatrix ergänzt diese Bewertung. Sie zeigt beispielsweise, ob eine Cloud-Anwendung weiterhin auf eine lokale Datenbank zugreift oder ob mehrere Anwendungen denselben Authentifizierungsdienst benötigen. Solche Abhängigkeiten können unerwartete Engpässe verursachen, wenn einzelne Komponenten isoliert migriert werden.
Auch das Zielbetriebsmodell sollte vor der Technologieauswahl feststehen. Für jede Komponente muss geklärt sein, wer Überwachung, Wartung, Wiederherstellung und Eskalation verantwortet. Bei mehreren Dienstleistern braucht es zusätzlich eine eindeutige Zuständigkeit für Fehler an den Übergängen zwischen den Betriebsumgebungen.
Damit die fünf Bausteine tatsächlich zu einer umsetzbaren Architektur werden, empfiehlt sich ein dokumentiertes Planungsmodell mit konkreten Ergebnissen:
Checkliste für die Planung einer hybriden IT-Infrastruktur
- Alle Anwendungen und Systeme erfassen und ein Workload-Inventar mit Betriebsort, Verantwortlichem und Kritikalität erstellen.
- Personendaten und andere geschäftskritische Informationen klassifizieren und eine dokumentierte Datenstandort-Matrix erstellen.
- Technische Abhängigkeiten zwischen Anwendungen, Datenbanken, Identitätsdiensten und Netzwerken in einer Abhängigkeitsmatrix festhalten.
- Die fünf Architekturbausteine definieren und eine dokumentierte Zielarchitektur mit Schnittstellen und Sicherheitsanforderungen erstellen.
- Verantwortlichkeiten für Monitoring, Backup, Incident Response, Kosten und Wiederherstellung in einer verbindlichen Betriebsmatrix zuweisen.
Wenn Daten und Anwendungen auf mehrere Betriebsorte verteilt werden, entscheidet insbesondere die Qualität der Netzwerkverbindung darüber, ob die Architektur auch unter realer Last zuverlässig funktioniert.
VPN oder direkte Verbindung: Welche Netzwerkanbindung eignet sich für stabile Workloads und sensible Daten?
VPN und dedizierte Cloud-Verbindungen erfüllen unterschiedliche Anforderungen und sind nicht grundsätzlich gegeneinander austauschbar. Ein VPN eignet sich für flexible Zugriffe, administrative Verbindungen und viele kleinere Datenübertragungen. Dedizierte Verbindungen können bei kontinuierlichen Datenströmen und planbaren Netzwerkleistungen sinnvoll sein. Die Entscheidung sollte anhand gemessener Bandbreite, Latenz, Jitter, Verfügbarkeit und Kosten erfolgen.
Ein VPN stellt eine verschlüsselte Verbindung über ein bestehendes Netzwerk her. Es lässt sich vergleichsweise flexibel zwischen Standorten, Rechenzentren und Cloud-Umgebungen einsetzen. Für administrative Zugriffe oder weniger zeitkritische Anwendungen kann diese Lösung ausreichen.
Eine dedizierte Verbindung stellt dagegen einen spezifisch bereitgestellten Netzwerkpfad zwischen Unternehmensinfrastruktur und Cloud-Anbieter her. Sie kann eine besser planbare Netzwerkleistung ermöglichen, ist aber mit zusätzlichen Anforderungen an Bereitstellung, Redundanz und laufenden Betrieb verbunden.
Wichtig ist die Unterscheidung zwischen Netzwerkverfügbarkeit und Ende-zu-Ende-Sicherheit. Eine dedizierte Verbindung garantiert nicht automatisch vollständige Vertraulichkeit. Verschlüsselung, Zugriffskontrollen, Segmentierung und Firewall-Regeln bleiben erforderlich. Umgekehrt ist ein VPN nicht grundsätzlich ungeeignet für produktive Unternehmensanwendungen.
| Kriterium | VPN | Dedizierte Verbindung |
|---|---|---|
| Bereitstellung | Flexibel über bestehende Netzwerke | Abhängig von Provider und Cloud-Anbieter |
| Bandbreite | Abhängig von Internetzugang und VPN-Gateway | Planbare Kapazität entsprechend dem gebuchten Anschluss |
| Latenz und Jitter | Abhängig von Internet-Routing und Netzwerklast | Kann bei geeignetem Routing besser planbar sein |
| Verschlüsselung | Durch VPN-Protokoll realisierbar | Zusätzliche Verschlüsselung kann erforderlich sein |
| Redundanz | Über alternative Internetzugänge und VPN-Endpunkte | Über unabhängige Leitungen und Provider zu planen |
| Betriebsaufwand | Konfiguration und Überwachung der VPN-Komponenten | Zusätzliche Koordination mit Netzwerkprovidern |
Für die Auswahl sollte zunächst die Art der Workload betrachtet werden. Eine Anwendung, die nur gelegentlich auf lokale Dateien zugreift, benötigt möglicherweise keine dedizierte Verbindung. Eine Cloud-Anwendung, die permanent Daten aus einer lokalen Datenbank abfragt, kann dagegen von einer planbaren Netzwerkanbindung profitieren.
Ein besonders wichtiger technischer Aspekt ist die Asymmetrie von Netzwerkpfaden. Wenn ausgehende und eingehende Daten unterschiedliche Routen nehmen, können Firewalls zustandsbehaftete Verbindungen falsch behandeln. Auch Routing, DNS-Auflösung und Fehlersuche werden dadurch komplizierter.
Ein hypothetisches Beispiel: Eine Cloud-Anwendung kommuniziert mit einer lokalen Datenbank über eine dedizierte Verbindung. Der Rückweg wird jedoch durch eine andere Routing-Regel über ein VPN geleitet. Unterschiedliche Firewall-Regeln oder Session-Zustände können dann Verbindungen unterbrechen, obwohl beide Netzwerkverbindungen grundsätzlich funktionieren.
Deshalb sollten Unternehmen Routing, DNS, Firewall-Regeln und Netzwerksegmentierung als zusammenhängendes Konzept dokumentieren. Für jede Verbindung sind Quelle, Ziel, Protokoll, erlaubte Richtung und zuständige Betriebsstelle festzuhalten.
Für geschäftskritische Verbindungen ist ausserdem ein Failover-Konzept erforderlich. Dabei müssen physische Leitungsredundanz, alternative Provider und unabhängige Routing-Pfade berücksichtigt werden. Zwei logische Verbindungen bieten keinen ausreichenden Schutz, wenn sie dieselbe physische Leitung oder denselben zentralen Netzwerkpunkt verwenden.
Eine technisch leistungsfähige Verbindung allein garantiert allerdings keine wirtschaftliche hybride Architektur. Werden Daten unnötig häufig zwischen Cloud und lokalen Systemen übertragen, können trotz guter Netzwerkleistung erhebliche Zusatzkosten entstehen.
Der Hybrid-Fehler, der durch unkontrollierte Datenübertragungen unerwartet hohe Cloud-Rechnungen verursacht
Ein häufiger Kostenfehler hybrider Infrastrukturen besteht darin, nur gespeicherte Datenmengen zu kalkulieren und die laufenden Datenübertragungen zu unterschätzen. Wiederholte Synchronisierungen, Replikationen, API-Aufrufe und ausgehender Datentransfer können zusätzliche Cloud-Kosten verursachen, selbst wenn das eigentliche Speichervolumen nahezu unverändert bleibt.
Besonders problematisch ist eine Architektur, bei der eine Anwendung in der Cloud betrieben wird, während ihre zentrale Datenbank lokal verbleibt. Die Anwendung fragt dann möglicherweise kontinuierlich lokale Daten ab. Werden grosse Datenmengen bei jeder Anfrage übertragen, steigen sowohl Netzwerkbelastung als auch potenzielle Verbrauchskosten.
Auch Backup- und Analyseprozesse können unnötige Übertragungen erzeugen. Werden dieselben Daten mehrfach repliziert oder regelmässig vollständige Synchronisierungen statt inkrementeller Aktualisierungen durchgeführt, entstehen vermeidbare Datenbewegungen.
Eine Data-Flow-Matrix macht diese Zusammenhänge sichtbar. Für jeden Datenstrom sollten mindestens folgende Angaben dokumentiert werden:
- Quelle und Ziel der Übertragung.
- Übertragungsrichtung und verwendetes Protokoll.
- Datenvolumen pro Übertragung und Zeitraum.
- Häufigkeit und Auslöser der Synchronisierung.
- Geschäftlicher Zweck und verantwortliche Anwendung.
- Erforderliche Aufbewahrung, Replikation und Wiederherstellung.
Auf dieser Grundlage lassen sich unnötige Vollsynchronisierungen, redundante Kopien und übermässige API-Kommunikation identifizieren. Besonders wichtig ist die Betrachtung zusammenhängender Workloads. Compute und Daten sollten möglichst anhand ihrer Kommunikationsabhängigkeiten gemeinsam bewertet werden.
Ein wirksames Gegenmodell ist FinOps für hybride Datenflüsse. Dabei werden nicht nur Server und Storage, sondern auch Netzwerk-Egress, Replikation, API-Nutzung, Backup-Transfers und Wiederherstellungsoperationen berücksichtigt.
Die Kosten sollten nach Möglichkeit den verantwortlichen Anwendungen oder Geschäftsbereichen zugeordnet werden. Budgets und Verbrauchswarnungen werden dadurch aussagekräftiger. Eine steigende Netzwerkrechnung lässt sich beispielsweise mit einem erhöhten Datenvolumen einer bestimmten Anwendung in Verbindung bringen.
Technische Kennzahlen sind dabei genauso wichtig wie finanzielle Werte. Unternehmen sollten Datenvolumen, Übertragungsfrequenz, API-Aufrufe und Replikationsintervalle mit den tatsächlichen Cloud-Kosten vergleichen. So werden ungewöhnliche Verbrauchsmuster sichtbar, bevor sie sich über längere Zeiträume fortsetzen.
Auch die Datenplatzierung muss regelmässig überprüft werden. Eine Anwendung mit hoher lokaler Datenbankabhängigkeit ist nicht automatisch für einen vollständigen Cloud-Betrieb geeignet. In manchen Fällen ist es wirtschaftlicher, die Anwendung lokal zu belassen oder Anwendung und Datenbank gemeinsam zu verlagern.
Hypothetisches Beispiel: Unterschätzte Datenbankkommunikation
Ein Unternehmen betreibt seine Datenbank weiterhin im lokalen Rechenzentrum und verlagert die zugehörige Anwendung in eine Cloud-Umgebung. Die Anwendung liest bei zahlreichen Geschäftsprozessen Daten aus dem lokalen System. Werden diese Zugriffe nicht gebündelt oder optimiert, können wiederkehrende Datenübertragungen die Netzwerkbelastung und die laufenden Betriebskosten erhöhen.
Die geeignete Gegenmassnahme besteht darin, Datenflüsse zu messen, Abfrageverhalten zu analysieren und die Platzierung zusammengehöriger Komponenten erneut zu bewerten. Das Beispiel beschreibt ein mögliches Architekturszenario, keinen dokumentierten Unternehmensfall.
Ein weiterer Kostenfaktor sind Wiederherstellungsoperationen. Backups müssen nicht nur gespeichert, sondern bei Bedarf auch übertragen und wieder eingespielt werden. Die Kosten und die verfügbare Bandbreite sollten deshalb bereits bei der Planung der Disaster-Recovery-Architektur berücksichtigt werden.
Nach der technischen und wirtschaftlichen Bewertung stellt sich die Frage, mit welchen Anwendungen Unternehmen die hybride Architektur am sinnvollsten einführen können.
Welche 3 Workloads sollten zuerst hybrid werden, damit das Migrationsrisiko gering bleibt?
Für den Einstieg eignen sich vor allem Workloads, deren Abhängigkeiten überschaubar sind und deren Ausfall keine unmittelbaren geschäftskritischen Prozesse unterbricht. Besonders geeignet können Entwicklungs- und Testumgebungen, ausgewählte Kollaborationsdienste sowie Backup- und Archivierungskomponenten sein. Die tatsächliche Priorität hängt jedoch von Datenklassifizierung, Integrationsaufwand, Wiederherstellbarkeit und laufenden Kosten ab.
Die erste Kategorie sind Entwicklungs- und Testumgebungen. Ihr Ressourcenbedarf schwankt häufig stärker als der produktiver Systeme. Cloud-Ressourcen können hier eine flexible Bereitstellung ermöglichen, wenn keine unzulässigen Produktivdaten verwendet werden und die erforderlichen Sicherheitskontrollen vorhanden sind.
Die zweite Kategorie umfasst Kollaborations- und Kommunikationsdienste. Solche Anwendungen können sich für SaaS-Integrationen eignen, sofern Identitätsverwaltung, Datenstandort, Berechtigungen und Schnittstellen sauber geregelt sind. Die Integration sollte insbesondere die Synchronisierung von Benutzerkonten und den kontrollierten Austausch geschäftlicher Informationen berücksichtigen.
Die dritte Kategorie sind ausgewählte Backup-, Archivierungs- und Disaster-Recovery-Komponenten. Cloud-Speicher oder externe Wiederherstellungsressourcen können eine zusätzliche Ebene der Datensicherung schaffen. Dabei müssen Wiederherstellungszeiten, Datenübertragungsvolumen, Verschlüsselung und Abhängigkeiten von Netzwerkverbindungen geprüft werden.
Die Reihenfolge der Migration sollte nicht allein durch technische Einfachheit bestimmt werden. Ein Workload-Scoring bietet eine bessere Grundlage. Dabei werden beispielsweise geschäftliche Kritikalität, Datenklassifizierung, technische Abhängigkeiten, Migrationsaufwand, Rückkehrmöglichkeit und erwartete Kosten bewertet.
Ein solcher Vergleich hilft, Anwendungen mit einem günstigen Verhältnis zwischen Nutzen und Risiko zu identifizieren. Ein technisch einfach migrierbarer Dienst kann beispielsweise ungeeignet sein, wenn er sensible Daten verarbeitet oder von zahlreichen lokalen Schnittstellen abhängig ist.
Vor dem produktiven Übergang empfiehlt sich ein Pilotmodell mit begrenztem Nutzerkreis. Der parallele Betrieb ermöglicht es, die neue Umgebung mit der bestehenden Lösung zu vergleichen. Besonders wichtig sind Tests zur Datenkonsistenz, Rechtevergabe, Antwortzeit und Wiederherstellung.
Auch das Verhalten bei einer unterbrochenen Verbindung muss überprüft werden. Eine Cloud-Anwendung, die ohne Zugriff auf lokale Systeme nicht mehr funktioniert, benötigt eine entsprechende Ausfallstrategie. Vor Beginn der Migration muss ausserdem ein dokumentierter Rollback-Pfad existieren.
Ein Gegenfall sind Anwendungen mit engen Echtzeitabhängigkeiten, nicht unterstützten Legacy-Schnittstellen oder besonders hohen Anforderungen an lokale Datenverarbeitung. Solche Systeme sollten nicht allein aus Modernisierungsgründen zuerst migriert werden. Wenn eine Verlagerung zusätzliche Latenz, neue Fehlerquellen oder unverhältnismässige Kosten erzeugt, kann der lokale Betrieb vorerst die sinnvollere Lösung bleiben.
Ein Readiness-Assessment sollte deshalb nicht nur die technische Migrationsfähigkeit bewerten. Es muss auch klären, ob die Organisation die neue Umgebung sicher betreiben, überwachen und bei einem Fehler wiederherstellen kann.
Entscheidungspunkte für den nächsten Integrationsschritt
- Eine erfolgreiche Migration setzt voraus, dass Identitäten, Berechtigungen und Datenflüsse bereits vor dem produktiven Betrieb abgestimmt sind.
- Die technische Integration neuer Anwendungen benötigt verbindliche Schnittstellen, Datenverträge und einheitliche Betriebsstandards.
- Erst mit messbarer Kapazität, definierten Wiederherstellungszielen und getesteter Redundanz lässt sich die Verfügbarkeit geschäftskritischer Workloads zuverlässig planen.
Damit neue Anwendungen nicht bei jeder Einführung individuell angebunden werden müssen, braucht die hybride Infrastruktur verbindliche Integrationsstandards.
Wie definieren Sie 5 Integrationsstandards, damit neue Tools nahtlos in Ihre hybride IT-Infrastruktur eingebunden werden?
Neue Tools lassen sich dann zuverlässig in eine hybride IT-Infrastruktur integrieren, wenn sie fünf verbindliche technische Mindeststandards erfüllen: Identität und Authentifizierung, Datenaustausch, Schnittstellen und Versionierung, Protokollierung und Monitoring sowie automatisierte Bereitstellung und Konfiguration. Diese Standards bilden einen gemeinsamen Integrationsvertrag für lokale und cloudbasierte Anwendungen.
Der erste Standard betrifft Identität und Authentifizierung. Anwendungen sollten etablierte Verfahren wie OpenID Connect und SAML unterstützen, damit Benutzerkonten nicht für jede Plattform separat verwaltet werden müssen. Zusätzlich ist zu definieren, wie Rollen, Gruppen und privilegierte Berechtigungen übernommen werden.
Der zweite Standard regelt den Datenaustausch. APIs sollten dokumentiert, Datenformate eindeutig festgelegt und Übertragungsfehler nachvollziehbar behandelt werden. Ein erfolgreicher technischer API-Aufruf bedeutet nicht automatisch, dass die übertragenen Geschäftsdaten vollständig und korrekt sind.
Der dritte Standard betrifft Schnittstellen und Versionierung. Unternehmen sollten definieren, wie APIs geändert werden dürfen, wie lange ältere Versionen unterstützt werden und wie inkompatible Anpassungen kommuniziert werden. Dadurch lassen sich unerwartete Integrationsabbrüche vermeiden.
Der vierte Standard umfasst zentrale Protokollierung und Monitoring. Anwendungen müssen relevante Ereignisse, Fehler und technische Kennzahlen in einer auswertbaren Form bereitstellen. Einheitliche Zeitstempel, Korrelationskennungen und nachvollziehbare Fehlercodes erleichtern die Diagnose über mehrere Betriebsumgebungen hinweg.
Der fünfte Standard definiert automatisierte Bereitstellung und Konfiguration. Neue Anwendungen sollten möglichst reproduzierbar eingerichtet werden können. Dazu gehören dokumentierte Konfigurationsparameter, sichere Verwaltung von Zugangsdaten und eine kontrollierte Freigabe von Änderungen.
Ein API- oder Integrations-Gateway kann diese Standards unterstützen. Es ermöglicht unter anderem zentrale Authentifizierung, Rate Limiting, Schema-Validierung, Versionierung und Überwachung. Dadurch werden direkte Punkt-zu-Punkt-Verbindungen zwischen Cloud-Diensten und lokalen Anwendungen reduziert.
Allerdings ist ein Gateway nicht automatisch für jede Integration notwendig. Bei einfachen Datenübertragungen oder wenigen stabilen Schnittstellen kann zusätzliche Middleware unnötige Latenz und Betriebsaufwand verursachen. Entscheidend ist, ob die zentrale Vermittlung tatsächlich Kontrolle und Wiederverwendbarkeit verbessert.
Eine weitere Grundlage ist das Datenvertragsmodell (Data Contract). Es legt fest, welche Daten übertragen werden, welche Pflichtfelder existieren, wer für die Datenqualität verantwortlich ist und wie häufig Aktualisierungen erfolgen. Besonders bei Kunden-, Produkt- oder Finanzdaten verhindert eine solche Vereinbarung widersprüchliche Datenbestände.
Ein Datenvertrag sollte mindestens folgende Elemente enthalten:
- Definierte Datenstruktur und eindeutige Feldbezeichnungen.
- Verbindliche Pflichtfelder und zulässige Werte.
- Verantwortlichkeiten für Datenqualität und Aktualisierung.
- Festgelegte Übertragungsfrequenz und Synchronisierungslogik.
- Fehlerbehandlung, Wiederholungsversuche und Konfliktauflösung.
Die Plug-in-Fähigkeit einer neuen Anwendung lässt sich anschliessend mit einem standardisierten Integrationstest überprüfen. Dabei werden Anmeldung, Rechtevergabe, API-Kommunikation, Datenvalidierung, Protokollierung, Fehlerbehandlung und Wiederherstellung getestet.
Eine zusätzliche Exit-Anforderung verhindert langfristige Abhängigkeiten von proprietären Schnittstellen. Vor der Einführung sollte geklärt sein, wie vollständige Datenexporte funktionieren und wie eine Anwendung bei einem Anbieterwechsel ersetzt werden kann.
Damit entsteht ein wiederverwendbares Integrationsmodell: Neue Tools müssen nicht jedes Mal eine eigene Architektur erhalten, sondern können gegen dieselben technischen und organisatorischen Anforderungen geprüft werden.
Mit standardisierten Integrationen lässt sich die Infrastruktur systematisch erweitern. Damit die Leistung auch bei steigender Nutzung ausreicht, muss die verfügbare Serverkapazität anhand tatsächlicher Messwerte geplant werden.
Wie planen Sie die Serverkapazität anhand von 6 Messwerten statt nach Bauchgefühl?
Eine belastbare Serverkapazitätsplanung benötigt sechs zentrale Messwerte: CPU-Auslastung, RAM-Auslastung und Speicherbedarf, Storage-IOPS beziehungsweise Storage-Latenz, Netzwerkdurchsatz, gleichzeitige Benutzer oder Transaktionen sowie das Wachstum der Workload-Last. Erst die gemeinsame Auswertung dieser Kennzahlen zeigt, wo tatsächliche Engpässe entstehen und welche Ressourcen erweitert werden müssen.
Die CPU-Auslastung zeigt, wie stark die verfügbaren Rechenressourcen beansprucht werden. Durchschnittswerte allein reichen jedoch nicht aus. Kurzfristige Spitzen, wiederkehrende Lastspitzen und zeitliche Nutzungsmuster müssen ebenfalls erfasst werden.
Der zweite Messbereich umfasst RAM-Auslastung und Speicherbedarf. Zu wenig Arbeitsspeicher kann Auslagerungsvorgänge verursachen und dadurch die Anwendungsleistung reduzieren. Auch die tatsächliche Speicherentwicklung sollte berücksichtigt werden, insbesondere bei wachsenden Datenbanken und Anwendungen mit hohen Zwischenspeicheranforderungen.
Der dritte Messwertbereich betrifft Storage. IOPS beschreiben die Anzahl der Ein- und Ausgabeoperationen pro Sekunde. Die Storage-Latenz zeigt dagegen, wie lange einzelne Speicherzugriffe benötigen. Beide Kennzahlen müssen gemeinsam betrachtet werden, da eine hohe I/O-Auslastung nicht automatisch eine unzureichende Speicherleistung bedeutet.
Der vierte Messwert ist der Netzwerkdurchsatz. Er zeigt, wie viele Daten innerhalb eines bestimmten Zeitraums übertragen werden. Für hybride Workloads sind zusätzlich Latenz, Paketverluste und zeitliche Schwankungen relevant, insbesondere wenn Anwendungen regelmässig auf lokale Datenbanken zugreifen.
Der fünfte Messwert erfasst die Anzahl gleichzeitiger Benutzer oder Transaktionen. Diese Kennzahl verbindet technische Ressourcen mit der tatsächlichen Nutzung der Anwendungen. Ein Server kann beispielsweise eine niedrige CPU-Auslastung aufweisen, während die Antwortzeiten bei vielen parallelen Datenbankzugriffen bereits problematisch werden.
Der sechste Messwert ist das Wachstum der Workload-Last. Historische Nutzungsdaten helfen, saisonale Schwankungen und langfristige Entwicklungen zu erkennen. Dadurch lassen sich Erweiterungen rechtzeitig planen, statt erst nach einem Leistungseinbruch zu reagieren.
Die Messungen sollten über repräsentative Geschäftszyklen erfolgen. Dabei sind Grundlast, Spitzenlast und saisonale Schwankungen getrennt auszuwerten. Lokale Server und Cloud-Ressourcen müssen unter vergleichbaren Bedingungen gemessen werden, damit die Kapazitätsplanung nicht durch unterschiedliche Messmethoden verzerrt wird.
Besonders wichtig ist die gemeinsame Diagnose der Kennzahlen. Eine hohe Storage-Latenz kann beispielsweise dazu führen, dass eine Anwendung langsam reagiert, obwohl die CPU-Auslastung niedrig erscheint. Zusätzliche Rechenleistung würde das eigentliche Problem in diesem Fall nicht lösen.
Die Kapazitätsprognose sollte deshalb historische Nutzung, erwartetes Wachstum, Lizenzkosten, Reservierungen, lokale Hardware-Erneuerung und Cloud-Spitzenlasten zusammenführen. Bei jeder Workload ist ausserdem zu prüfen, ob dynamische Skalierung technisch und lizenzrechtlich möglich ist.
Für eine nachvollziehbare Planung empfiehlt sich eine Kapazitätsübersicht mit folgenden Angaben:
| Messbereich | Wichtige Kennzahl | Planungsnutzen |
|---|---|---|
| CPU | Auslastung und Lastspitzen | Rechenkapazität bewerten |
| Arbeitsspeicher | RAM-Nutzung und Speicherbedarf | Speicherengpässe erkennen |
| Storage | IOPS und Latenz | Speicherleistung beurteilen |
| Netzwerk | Durchsatz und Übertragungsverhalten | Kommunikationsengpässe identifizieren |
| Workload-Nutzung | Gleichzeitige Benutzer und Transaktionen | Technische Leistung mit Nutzung verbinden |
| Wachstum | Entwicklung der Workload-Last | Zukünftigen Kapazitätsbedarf prognostizieren |
Die Ergebnisse sollten anschliessend in ein gemeinsames Kosten- und Skalierungsmodell einfliessen. Damit lässt sich vergleichen, ob eine zusätzliche lokale Serverkapazität, eine Cloud-Erweiterung oder eine Optimierung bestehender Ressourcen wirtschaftlich sinnvoller ist.
Kapazität allein genügt jedoch nicht, wenn Anwendungen eine definierte Verfügbarkeit erreichen müssen. Dafür müssen Redundanz, Wiederherstellung und gemeinsame Fehlerursachen berücksichtigt werden.
Wie dimensionieren Sie Ihre Serverinfrastruktur, wenn eine Verfügbarkeit von 99,9 % gefordert ist?
Eine geforderte Verfügbarkeit von 99,9 % bedeutet, dass ein Dienst über den vereinbarten Messzeitraum höchstens 0,1 % der Zeit nicht verfügbar sein darf. Bei einer Betrachtung über 365 Tage entspricht das rund 8,76 Stunden maximaler Ausfallzeit pro Jahr. Die Serverinfrastruktur muss deshalb nicht nur ausreichend dimensioniert sein, sondern auch redundante Komponenten, definierte Wiederherstellungsziele und regelmässig getestete Ausfallmechanismen besitzen.
99,9 % = 8,76 Stunden
Theoretisch zulässige Ausfallzeit pro Jahr bei einer zeitbasierten Verfügbarkeitsmessung über 365 Tage. Die Berechnung berücksichtigt keine abweichenden Vertragsregelungen oder besonderen Wartungsausschlüsse.
Grundlage: Google-SRE-Tabelle zur Serviceverfügbarkeit.
Die rechnerische Verfügbarkeit ist allerdings nicht automatisch mit einer vertraglichen SLA gleichzusetzen. Unternehmen müssen festlegen, wie die Verfügbarkeit gemessen wird, welche Wartungsfenster gelten und welche Ausnahmen im Servicevertrag vorgesehen sind. Auch die Frage, ob einzelne Funktionen oder der gesamte Dienst als ausgefallen gelten, beeinflusst die Bewertung.
Aus dem Verfügbarkeitsziel folgt die Notwendigkeit einer Architektur ohne einzelne kritische Fehlerpunkte. Dazu gehören redundante Stromversorgung, Netzwerkpfade, Storage-Komponenten und Serverinstanzen. Je nach Schutzbedarf können auch getrennte Ausfallzonen oder unabhängige Rechenzentrumsstandorte erforderlich sein.
Entscheidend ist die Analyse gemeinsamer Fehlerursachen. Zwei redundante Server bieten beispielsweise keinen ausreichenden Schutz, wenn beide an denselben Switch, dasselbe Storage-System oder denselben Stromkreis angeschlossen sind. Auch gemeinsame Identity Provider und zentrale DNS-Dienste können zu kritischen Abhängigkeiten werden.
Eine hybride Architektur sollte deshalb nicht nur die Redundanz einzelner Hardwarekomponenten betrachten. Vielmehr muss die gesamte Dienstekette analysiert werden: vom Benutzerzugriff über DNS und Authentifizierung bis zur Anwendung, Datenbank und Netzwerkverbindung.
Zusätzlich sind zwei Wiederherstellungsziele festzulegen. Das Recovery Time Objective (RTO) beschreibt, innerhalb welcher Zeit ein System nach einem Ausfall wiederhergestellt werden muss. Das Recovery Point Objective (RPO) definiert, wie viel Datenverlust maximal akzeptabel ist, ausgedrückt als Zeitraum seit der letzten wiederherstellbaren Datenversion.
Diese Ziele bestimmen, welche Wiederherstellungsarchitektur erforderlich ist. Bei strengen RTO- und RPO-Anforderungen können beispielsweise Replikation, zusätzliche lokale Ersatzsysteme oder Cloud-basierte Disaster-Recovery-Mechanismen notwendig werden.
Zwischen synchroner und asynchroner Replikation bestehen dabei wichtige Unterschiede. Synchrone Verfahren können bei geeigneter Architektur einen geringeren Datenverlust ermöglichen, benötigen jedoch passende Netzwerkbedingungen und können die Schreiblatenz beeinflussen. Asynchrone Verfahren sind flexibler bei grösseren Entfernungen, können im Fehlerfall aber einen Datenverlust innerhalb des Replikationsintervalls verursachen.
Die konkrete Auswahl muss deshalb anhand der geschäftlichen Wiederherstellungsanforderungen erfolgen. Ein pauschales Redundanzmodell ist nicht ausreichend, weil Datenbank, Anwendung, Identitätsdienst und Netzwerk unterschiedliche technische Eigenschaften besitzen.
Auch die tatsächliche Verfügbarkeit muss regelmässig überprüft werden. Dazu gehören Failover-Übungen, Wiederherstellungstests und Ende-zu-Ende-Monitoring. Ein erreichbarer Server ist noch kein Nachweis dafür, dass Mitarbeitende ihre Geschäftsprozesse wieder ausführen können.
Ein vollständiger Wiederherstellungstest sollte deshalb unter anderem folgende Abhängigkeiten berücksichtigen:
- Erreichbarkeit und korrekte Auflösung der DNS-Dienste.
- Funktionsfähigkeit der Authentifizierung und Berechtigungen.
- Verfügbarkeit der Datenbanken und erforderlichen Datenbestände.
- Funktionierende Netzwerkverbindungen zwischen lokalen und Cloud-Komponenten.
- Erfolgreiche Ausführung der geschäftlichen Anwendung nach dem Failover.
Besonders bei hybriden Umgebungen ist die Wiederherstellung der Verbindungen zwischen den Betriebsorten entscheidend. Ein lokales Ersatzsystem kann technisch verfügbar sein, aber dennoch ausfallen, wenn die erforderlichen Identitätsdienste, Datenbanken oder externen Schnittstellen nicht erreichbar sind.
Monitoring sollte deshalb nicht nur einzelne Infrastrukturkomponenten überwachen. Synthetische Transaktionstests und anwendungsbezogene Prüfungen zeigen, ob ein vollständiger Geschäftsprozess tatsächlich funktioniert. Die Ergebnisse müssen mit den vereinbarten RTO-, RPO- und Verfügbarkeitszielen abgeglichen werden.
Für die Umsetzung empfiehlt sich deshalb eine Architektur, die technische Abhängigkeiten transparent macht, Ausfälle kontrolliert abfangen kann und regelmässig unter realistischen Bedingungen getestet wird. So wird die hybride IT-Infrastruktur zu einer belastbaren Grundlage für Cloud-Flexibilität und lokale Datenkontrolle.
Was ist der Unterschied zwischen Hybrid Cloud und Multi-Cloud?
Eine Hybrid Cloud verbindet lokale IT-Infrastruktur mit Cloud-Diensten und ermöglicht die gemeinsame Nutzung beider Betriebsumgebungen. Multi-Cloud bezeichnet dagegen die Nutzung mehrerer Cloud-Anbieter. Beide Konzepte können kombiniert werden, verfolgen jedoch unterschiedliche Architekturziele. Eine hybride Umgebung kann beispielsweise ein lokales Rechenzentrum mit einer Public Cloud verbinden und zusätzlich Dienste eines zweiten Cloud-Anbieters integrieren.
Müssen sensible Unternehmensdaten in der Schweiz gespeichert werden?
Das Schweizer Datenschutzgesetz schreibt nicht pauschal vor, dass sämtliche Personendaten ausschliesslich in der Schweiz gespeichert werden müssen. Bei einer Bearbeitung im Ausland sind jedoch die geltenden Anforderungen an internationale Datenübermittlungen zu beachten. Unternehmen müssen ausserdem die Verantwortlichkeiten des Cloud-Anbieters, Sicherheitsmassnahmen, Unterauftragsbearbeiter und vertraglichen Regelungen prüfen. Branchenspezifische Anforderungen können zusätzliche Einschränkungen vorsehen.
Ist eine hybride IT-Infrastruktur automatisch sicherer als eine reine Cloud-Lösung?
Nein. Eine hybride Infrastruktur bietet zusätzliche Möglichkeiten zur Kontrolle von Datenstandorten und lokalen Systemen, erhöht aber gleichzeitig die Anzahl technischer Schnittstellen und potenzieller Fehlerquellen. Die Sicherheit hängt von einer konsistenten Identitätsverwaltung, Netzwerksegmentierung, Verschlüsselung, Berechtigungssteuerung, Überwachung und Wiederherstellung ab. Ohne einheitliches Sicherheitskonzept kann die hybride Architektur sogar zusätzliche Risiken erzeugen.
Wie lange dauert die Einführung einer hybriden IT-Infrastruktur?
Die Einführungsdauer hängt von der Anzahl der Workloads, der Komplexität bestehender Systeme, den Datenabhängigkeiten und den Sicherheitsanforderungen ab. Eine einfache Integration einzelner Entwicklungsumgebungen unterscheidet sich erheblich von der Migration geschäftskritischer Anwendungen mit lokalen Datenbanken. Eine belastbare Zeitplanung entsteht erst nach einem Infrastrukturinventar, einer Abhängigkeitsanalyse und einem definierten Pilotprojekt.
Welche Kennzahlen sollten Unternehmen beim Betrieb einer hybriden Infrastruktur überwachen?
Wichtige Kennzahlen sind CPU- und RAM-Auslastung, Storage-IOPS und Latenz, Netzwerkdurchsatz, gleichzeitige Benutzer und Transaktionen sowie das Wachstum der Workload-Last. Zusätzlich sollten Unternehmen Datenübertragungsvolumen, Cloud-Kosten, Sicherheitsereignisse, Backup-Erfolg, Wiederherstellungszeiten und tatsächliche Dienstverfügbarkeit überwachen. Die Kennzahlen müssen gemeinsam ausgewertet werden, damit technische Engpässe und wirtschaftliche Abweichungen frühzeitig sichtbar werden.