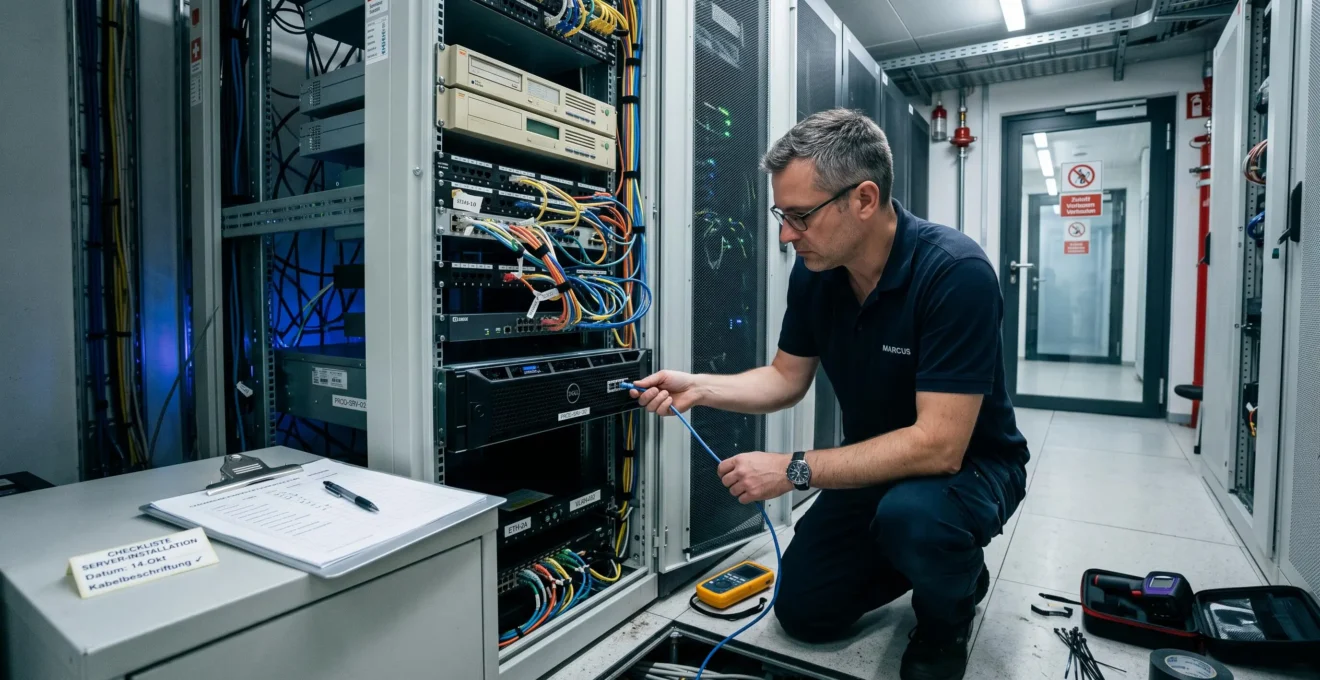
Eine Produktionsanlage reagiert verzögert, weil eine Anwendung auf einen entfernten Dienst wartet. Ein Standort verliert seine Internetverbindung und kann nicht mehr auf geschäftskritische Systeme zugreifen. Oder eine bestehende Serverumgebung läuft zuverlässig, während ihre Ablösung durch Cloud-Dienste höhere laufende Kosten verursachen würde. In solchen Situationen ist die Cloud nicht automatisch die bessere Architektur.
On-Premise-Infrastruktur lohnt sich weiterhin, wenn lokale Verarbeitung, vorhersehbare Auslastung, kontrollierbare Abhängigkeiten oder besondere Betriebsanforderungen den Ausschlag geben. Entscheidend ist allerdings, dass die eigene Umgebung nicht nur weiterbetrieben, sondern systematisch modernisiert wird. Veraltete Hardware, unklare Zuständigkeiten und fehlende Wiederherstellungsverfahren können die vermeintliche Unabhängigkeit schnell zum Risiko machen.
Für Schweizer Unternehmen stellt sich deshalb weniger die Frage «Cloud oder On-Premise?», sondern welche Anwendungen unter welchen Bedingungen zuverlässig, wirtschaftlich und rechtskonform betrieben werden können. Dafür braucht es belastbare Betriebsdaten, eine nachvollziehbare Kostenrechnung und einen Modernisierungspfad, der bestehende Dienste möglichst wenig beeinträchtigt. Auch hybride Architekturen können dabei sinnvoll sein.
On-Premise modernisieren: die wichtigsten Entscheidungen
- On-Premise kann bei konstanten Workloads, kritischen lokalen Abhängigkeiten und langfristiger Nutzung wirtschaftlich oder betrieblich vorteilhaft sein. Eine individuelle Gesamtkostenrechnung bleibt notwendig.
- Eine sichere Modernisierung beginnt mit Inventar und Messdaten, setzt auf kontrollierte Migrationsschritte und verlangt getestete Backup- und Rückkehrverfahren.
- Storage, Compute, Verwaltungsaufwand und Redundanz müssen gemeinsam geplant werden. Die angestrebte Verfügbarkeit bestimmt, welche Reserven und Schutzmassnahmen erforderlich sind.
- Warum On-Premise in bestimmten Fällen günstiger und stabiler sein kann als Cloud
- Wie modernisieren Sie On-Prem in 3 Etappen, ohne den Betrieb zu unterbrechen?
- Hyperconverged oder klassisch: Was passt bei kleinem Admin-Team?
- Der Fehler ‘Alles selbst bauen’, der Wartung zur Dauerbaustelle macht
- Wann sollten Sie Storage vor Compute erneuern, damit Performance nicht kippt?
- Wie erstellen Sie ein Hardware-Inventar in 7 Tagen, ohne teures Tool?
- Wie planen Sie Serverkapazität mit 6 Messwerten statt Bauchgefühl?
- Wie dimensionieren Sie Serverinfrastruktur, wenn 99,9% Verfügbarkeit gefordert wird?
Warum On-Premise in bestimmten Fällen günstiger und stabiler sein kann als Cloud
On-Premise kann günstiger sein, wenn Anwendungen dauerhaft mit gut vorhersehbarer Last laufen und vorhandene Hardware wirtschaftlich genutzt wird. Betriebliche Vorteile entstehen, wenn kritische Prozesse unabhängig von externen Internetverbindungen funktionieren müssen. Beides gilt jedoch nur, wenn lokale Infrastruktur, Personal, Wartung und Ausfallschutz die jeweiligen Anforderungen tatsächlich erfüllen.
Bei der Wirtschaftlichkeit zählt nicht der Anschaffungspreis eines Servers, sondern die Total Cost of Ownership (TCO) über einen vergleichbaren Zeitraum. Für eine Betrachtung über fünf bis sieben Jahre gehören auf der On-Premise-Seite Hardware, Ersatzinvestitionen, Strom, Kühlung, Stellfläche, Lizenzen, Support, Backup und Administrationsstunden dazu. Bei Cloud-Diensten müssen neben Rechenleistung und Speicher insbesondere Netzwerkverkehr, Datentransfer, Support, Backup und Betriebsaufwand berücksichtigt werden.
Ein vereinfachtes, ausdrücklich hypothetisches Szenario verdeutlicht den Unterschied: Eine Anwendung verarbeitet täglich ähnliche Datenmengen, benötigt praktisch durchgehend dieselbe Rechenleistung und verändert ihre Kapazitätsanforderungen nur langsam. Hier kann sich eine vorhandene lokale Infrastruktur wirtschaftlich rechnen. Eine stark schwankende Anwendung mit unregelmässigen Lastspitzen kann dagegen von elastisch bereitgestellten Cloud-Ressourcen profitieren. Das tatsächliche Ergebnis hängt von Preisen, Nutzungsdauer und Betriebsmodell ab.
Auch Stabilität muss getrennt bewertet werden. Lokal erreichbare Anwendungen können bei einem Internetausfall weiterarbeiten, sofern sie keine externen Dienste benötigen. Gleichzeitig trägt das Unternehmen die Verantwortung für Stromversorgung, Hardwareersatz und Wiederherstellung. Ein lokaler Stromausfall oder ein Defekt ohne Redundanz kann die gesamte Umgebung beeinträchtigen.
Für Schweizer Unternehmen kommt der Datenschutz hinzu. Der Eidgenössische Datenschutz- und Öffentlichkeitsbeauftragte erläutert in seinen Informationen des EDÖB zum Cloud-Computing, dass Unternehmen auch beim Einsatz externer Cloud-Dienste für die rechtmässige Bearbeitung ihrer Personendaten verantwortlich bleiben. Vertragsbedingungen, technische Schutzmassnahmen und mögliche Bekanntgaben ins Ausland sind deshalb zu prüfen. Daraus folgt aber weder eine generelle Pflicht zur lokalen Datenhaltung noch eine automatische Datenschutzkonformität von On-Premise.
Für die Entscheidung hilft eine getrennte Bewertung:
| Kriterium | On-Premise tendenziell vorteilhaft | Cloud tendenziell vorteilhaft |
|---|---|---|
| Auslastung | Konstant und langfristig planbar | Stark schwankend oder kurzfristig wachsend |
| Latenz | Direkte lokale Verarbeitung erforderlich | Anwendungen tolerieren entfernte Verarbeitung |
| Betrieb | Lokales Know-how und geeignete Redundanz vorhanden | Eigene Infrastrukturkapazitäten begrenzt |
| Datenschutz | Besondere Anforderungen lassen sich lokal einfacher erfüllen | Vertragliche und technische Anforderungen sind extern erfüllbar |
| Investitionen | Längerfristige Kapitalbindung akzeptabel | Verbrauchsabhängige Kostenstruktur erwünscht |
Erst wenn beide Kriterien zusammen mit Datenschutz, Latenz und Wiederherstellbarkeit betrachtet werden, lässt sich bestimmen, welche Systeme lokal bleiben sollten. Für diese Systeme folgt die nächste Frage: Wie lässt sich die vorhandene Umgebung erneuern, ohne unnötige Betriebsrisiken einzugehen?
Wie modernisieren Sie On-Prem in 3 Etappen, ohne den Betrieb zu unterbrechen?
Eine On-Premise-Modernisierung gelingt mit möglichst geringen Unterbrechungen, wenn sie in drei Etappen erfolgt: zuerst Bestand und Risiken erfassen, danach die neue Umgebung parallel aufbauen und testen, schliesslich kontrolliert umschalten und Altlasten ausser Betrieb nehmen. Kritisch sind überprüfbare Übergabekriterien, konsistente Daten und ein getesteter Rückkehrplan. Eine vollständig unterbrechungsfreie Migration ist nicht bei jedem System möglich.
Etappe 1: Bestandsaufnahme und Priorisierung. Zunächst werden Server, Anwendungen, Datenbestände, Schnittstellen und technische Abhängigkeiten dokumentiert. Für jedes kritische System müssen Verantwortliche, Wartungsfenster, Backup-Status sowie zulässige Ausfall- und Datenverlustzeiten bekannt sein. Die Etappe ist abgeschlossen, wenn Risiken und Migrationsreihenfolge freigegeben sind und die Ausgangsumgebung wiederhergestellt werden kann.
Etappe 2: Parallelbetrieb und kontrollierte Umschaltung. Neue Hardware oder eine neue Virtualisierungsumgebung wird neben dem Bestand eingerichtet. Konfigurationen werden übernommen, Daten kontrolliert repliziert oder synchronisiert und Anwendungen unter realistischen Bedingungen getestet. Der produktive Datenverkehr wechselt erst nach erfolgreicher Prüfung zur neuen Umgebung.
Das Vorgehen orientiert sich am Blue-Green-Prinzip, das in Microsofts Architekturdokumentation zu Blue-Green-Deployments beschrieben wird. Die Dokumentation behandelt Azure-Architekturen; für lokale Datenbanken, Netzwerkinfrastrukturen und physische Server muss das Verfahren entsprechend angepasst werden.
Besondere Vorsicht ist bei schreibenden Datenbankanwendungen nötig. Nach der Umschaltung entstandene Daten dürfen bei einem Rollback nicht verloren gehen. Änderungen an Datenbankschemata oder inkompatible Softwareversionen können eine einfache Rückkehr verhindern. Eine geplante Rückkehroption muss daher technisch geprüft und nicht nur im Projektplan erwähnt werden.
Etappe 3: Stabilisieren und Altlasten abschalten. Nach der Umschaltung werden Performance, Fehlerraten, Backups und Wiederherstellungsverfahren überprüft. Erst wenn die vereinbarten Kriterien erfüllt sind, werden alte Systeme ausser Betrieb genommen, Datenbestände sicher behandelt und Inventare aktualisiert.
Fünf Prüfungen vor der produktiven Umschaltung
- Abhängigkeiten und Verantwortliche kontrollieren. Ergebnis: freigegebene System- und Schnittstellenliste.
- Backup und Wiederherstellung praktisch testen. Ergebnis: dokumentiertes Wiederherstellungsprotokoll.
- Datenkonsistenz zwischen alter und neuer Umgebung prüfen. Ergebnis: nachvollziehbarer Abgleichbericht.
- Umschaltung und Rückkehr unter definierten Bedingungen erproben. Ergebnis: getesteter Ablaufplan mit Abbruchkriterien.
- Betriebsteam und Fachverantwortliche einbinden. Ergebnis: Freigabeprotokoll mit Zuständigkeiten und Wartungsfenster.
Die Etappen sollten in den normalen Betriebsrhythmus integriert werden. Für ein Schweizer KMU kann ein geplantes Wartungsfenster ausserhalb von Monatsabschlüssen oder saisonalen Produktionsspitzen sinnvoller sein als eine umfassende Migration während der regulären Arbeitszeit.
Entscheidend ist anschliessend, ob die modernisierte Infrastruktur auch mit den vorhandenen personellen Ressourcen betreibbar bleibt. Genau daran entscheidet sich häufig die Wahl zwischen hyperkonvergenter und klassischer Architektur.
Hyperconverged oder klassisch: Was passt bei kleinem Admin-Team?
Für ein kleines IT-Team kann eine hyperkonvergente Infrastruktur (HCI) sinnvoll sein, weil Rechenleistung, Storage und Virtualisierung über eine integrierte Plattform verwaltet werden. Eine klassische Architektur bietet dagegen mehr Freiheit bei Komponenten und Ausbau. Welche Lösung besser passt, hängt vor allem von vorhandenem Know-how, Supportmodell, Wachstum und Herstellerabhängigkeiten ab.
HCI reduziert die Anzahl separat zu verwaltender Infrastrukturkomponenten. Bei passenden Plattformen lassen sich Überwachung, Ressourcenbereitstellung und Teile des Lifecycle-Managements zentralisieren. Das ist besonders interessant, wenn nur wenige Administratoren für den gesamten Betrieb verantwortlich sind.
Die Vereinfachung hat jedoch Grenzen: Firmware, Hypervisor, Cluster-Software und Hardware müssen weiterhin aufeinander abgestimmt und aktualisiert werden. Hinzu kommen Lizenzbedingungen, herstellerspezifische Erweiterungen und mögliche Einschränkungen bei der Skalierung einzelner Ressourcen.
Eine klassische Architektur mit getrennten Server-, Netzwerk- und Storage-Komponenten erlaubt eine unabhängigere Auswahl und Erneuerung einzelner Bausteine. Sie verlangt dafür meist breiteres Fachwissen über Schnittstellen, Kompatibilität, Fehleranalyse und den Betrieb verschiedener Managementsysteme.
Die folgende Entscheidungsmatrix zeigt Tendenzen, keine allgemeingültigen Produktempfehlungen.
| Kriterium | Hyperkonvergent (HCI) | Klassisch |
|---|---|---|
| Teamgrösse | Interessant bei wenig spezialisiertem Betriebspersonal | Geeignet bei breiterem Infrastrukturwissen |
| Virtualisierung | Integrierte Plattformkenntnisse notwendig | Bestehende Kenntnisse oft flexibel nutzbar |
| Budget | Plattform-, Lizenz- und Erweiterungskosten beachten | Komponenten lassen sich gezielter beschaffen |
| Herstellerbindung | Je nach Plattform deutlich ausgeprägt | Bei offenen Schnittstellen häufig geringer |
| Skalierung | Einfach bei passenden Ausbauprofilen, sonst Einschränkungen möglich | Compute und Storage häufig unabhängiger erweiterbar |
| Wartung | Integrierte, aber koordinierte Updates | Mehrere Komponenten separat zu pflegen |
Eine oft unterschätzte Schwachstelle ist die Abhängigkeit von Einzelpersonen. Wenn nur ein Administrator die Konfiguration einer individuell aufgebauten Umgebung versteht, entstehen bei Krankheit, Personalwechsel oder Störungen erhebliche Betriebsrisiken.
Die Technologieentscheidung sollte deshalb auch einen Vertretungstest bestehen: Können mindestens zwei entsprechend berechtigte Personen grundlegende Betriebsaufgaben ausführen, eine Störung eingrenzen und eine Wiederherstellung einleiten? Falls nicht, sind Dokumentation, Schulung oder externe Betriebsunterstützung erforderlich.
Eine integrierte Plattform kann den Betrieb vereinfachen, ersetzt aber keine Betriebsorganisation. Umgekehrt kann eine klassische Architektur sehr gut funktionieren, wenn sie standardisiert und nachvollziehbar aufgebaut ist. Problematisch wird es dort, wo individuelle Lösungen unkontrolliert wachsen.
Der Fehler ‘Alles selbst bauen’, der Wartung zur Dauerbaustelle macht
Eine vollständig selbst zusammengestellte Infrastruktur kann bei der Beschaffung günstig erscheinen, verursacht aber häufig zusätzlichen Aufwand im Betrieb. Individuelle Skripte, Sonderkonfigurationen und nicht standardisierte Komponenten erschweren Updates, Fehleranalysen und Personalvertretung. Eigenentwicklung lohnt sich vor allem dort, wo sie einen nachweisbaren technischen oder geschäftlichen Nutzen bringt und langfristig betreut werden kann.
Das eigentliche Problem ist selten eine einzelne selbst entwickelte Komponente. Es entsteht, wenn individuelle Lösungen ohne gemeinsame Standards kombiniert werden und das Wissen über ihre Abhängigkeiten ausschliesslich bei einzelnen Personen liegt.
Ein hypothetisches Beispiel: Ein Unternehmen betreibt seine Virtualisierung auf selbst zusammengestellten Servern. Backups werden durch individuelle Skripte angestossen, das Monitoring wurde über mehrere Jahre erweitert und Updates erfordern manuelle Eingriffe. Solange die verantwortliche Fachperson verfügbar ist, funktioniert das System. Beim Austausch einer Storage-Komponente zeigt sich jedoch, dass Skripte und Konfigurationen von veralteten Schnittstellen abhängen.
Die anfangs eingesparten Beschaffungskosten können durch wiederkehrende Fehlersuche, Dokumentationsnacharbeit und verlängerte Wartungsfenster aufgezehrt werden. Besonders kritisch ist, dass solche Abhängigkeiten spätere Migrationen erschweren.
On-Premise bedeutet nicht, jede Komponente selbst entwickeln zu müssen. Standardisierte Serverplattformen, vorkonfigurierte Backup-Systeme oder extern unterstütztes Monitoring können den eigenen Betrieb ergänzen. Die Daten und produktiven Anwendungen können weiterhin lokal betrieben werden, sofern Architektur, Zugriffsrechte und Verträge dies ermöglichen.
Individuelle Lösungen bleiben sinnvoll, wenn branchenspezifische Anforderungen, spezielle Schnittstellen oder technische Einschränkungen durch Standardprodukte nicht angemessen abgedeckt werden. Dann sollten Schnittstellen, Änderungen und Wiederherstellungsabläufe besonders sorgfältig dokumentiert werden.
Ein praktischer Kontrollpunkt lautet: Wie viele Personen können eine kritische Komponente ohne mündliche Anleitung warten oder wiederherstellen? Ist die Antwort lediglich eine Person, besteht unabhängig von der technischen Qualität ein organisatorisches Risiko.
Standardisierung reduziert nicht jede technische Komplexität, macht sie aber besser beherrschbar. Bevor eine bestehende Umgebung erneuert wird, sollte zudem geklärt werden, ob die Leistungsprobleme überhaupt von den Servern ausgehen oder zunächst beim Storage behoben werden müssen.
Wann sollten Sie Storage vor Compute erneuern, damit Performance nicht kippt?
Storage sollte vor Compute erneuert werden, wenn Messungen zeigen, dass Datenträgerlatenzen oder begrenzter I/O-Durchsatz die Anwendungen ausbremsen, während CPU und RAM ausreichende Reserven besitzen. Neue Server beseitigen einen bestehenden Storage-Engpass nicht automatisch. Umgekehrt wäre ein vorgezogener Storage-Austausch unwirtschaftlich, wenn die tatsächliche Ursache bei Prozessoren, Arbeitsspeicher oder Anwendungen liegt.
In virtualisierten Umgebungen teilen sich zahlreiche virtuelle Maschinen dieselben Storage-Ressourcen. Ein langsames oder überlastetes System kann dadurch mehrere Anwendungen gleichzeitig beeinträchtigen, selbst wenn die einzelnen Server genügend Rechenleistung bereitstellen.
Typische Warnsignale sind anhaltend hohe Lese- und Schreiblatenzen, lange Datenbankoperationen, ungewöhnlich langsame Anwendungen trotz geringer CPU-Auslastung oder Backups, die regelmässig länger als das verfügbare Zeitfenster benötigen. Diese Symptome sind Hinweise, aber noch kein Beweis für einen Storage-Engpass.
Für Windows Server erläutert Microsofts Anleitung zur Windows-Server-Performanceanalyse die Untersuchung von Datenträgerlatenzen mit integrierten Leistungsindikatoren.
15 / 25 / 50 ms
Microsoft nennt für die beschriebenen Windows-Datenträgerzähler Werte unter 15 ms als gesund, über 25 ms als Warnbereich und über 50 ms als kritisch. Diese Diagnose-Richtwerte sind keine universellen Grenzwerte für sämtliche Storage-Technologien oder Anwendungen. Auch Dauer, Lastprofil und betroffene Prozesse sind zu berücksichtigen.
Microsoft Learn, technische Anleitung zur Windows-Server-Performanceanalyse.
Eine belastbare Entscheidung vergleicht daher mindestens Storage-Latenz, I/O-Aktivität, CPU-Auslastung, RAM-Druck und Anwendungsantwortzeiten im selben Zeitraum. Zusätzlich sind Netzwerkverbindungen, Controller, Dateisysteme und die konkrete I/O-Charakteristik zu prüfen.
Bestätigt sich der Engpass, können Flash- oder NVMe-basierte Lösungen eine geeignete Modernisierung darstellen. Vor der Beschaffung sind Kompatibilität, geforderte Kapazität, Ausfallschutz, tatsächliches Lastprofil und Kosten zu prüfen. Erst nach einer erneuten Messung lässt sich feststellen, wie viel zusätzliche Compute-Leistung noch benötigt wird.
Auch der Lebenszyklus spielt eine Rolle. Mechanische Festplatten können durch Verschleiss ausfallen, während Controller, Firmware oder elektronische Komponenten ebenfalls technische Risiken aufweisen. Ausfälle lassen sich nicht allein aus dem Alter ableiten; Wartungsstatus, Fehlermeldungen und verfügbare Ersatzteile gehören zur Bewertung.
Damit solche Entscheidungen nicht auf Einzelbeobachtungen beruhen, braucht die IT-Leitung zunächst einen vollständigen Überblick über vorhandene Geräte und ihren Wartungszustand. Ein grundlegendes Inventar lässt sich auch ohne umfangreiche IT-Asset-Management-Plattform erstellen.
Wie erstellen Sie ein Hardware-Inventar in 7 Tagen, ohne teures Tool?
Ein erstes Hardware-Inventar lässt sich in sieben Arbeitstagen mit einer Tabellenkalkulation und vorhandenen Systemwerkzeugen erstellen. Erfasst werden Geräte, Standorte, technische Ausstattung, Softwarestände, Wartungsverträge und betriebliche Verantwortlichkeiten. Der Zeitrahmen ist ein pragmatisches Arbeitsziel für überschaubare Umgebungen, keine Garantie für die vollständige Erfassung komplexer Infrastrukturen.
Die Methode konzentriert sich auf Informationen, die unmittelbar für Modernisierung, Sicherheitsbewertung und Kapazitätsplanung benötigt werden. Wichtig ist eine gemeinsame Datenstruktur, damit Einträge verschiedener Administratoren vergleichbar bleiben.
Der Ablauf kann folgendermassen organisiert werden:
- Tag 1–2: Physische Server, Virtualisierungshosts und Appliances aufnehmen. Modell, Seriennummer, Standort, Funktion und verantwortliche Person erfassen.
- Tag 3–4: Betriebssysteme, Firmwarestände, Virtualisierungsplattformen und relevante Softwareversionen ergänzen. Unterstützungs- und Aktualisierungsstatus prüfen.
- Tag 5: Garantie, Supportverträge, Wartungsfristen und bekannte Ersatzteilrisiken dokumentieren.
- Tag 6: Netzwerkkomponenten und Storage-Systeme zuordnen. Schnittstellen, Abhängigkeiten und relevante Verbindungen sichtbar machen.
- Tag 7: Einträge kontrollieren, fehlende Informationen markieren und Systeme nach Kritikalität sowie Modernisierungsbedarf priorisieren.
Vorhandene Betriebssystem-, Virtualisierungs- und Geräteverwaltungsfunktionen können viele Angaben automatisiert liefern. Das reduziert manuelle Arbeit und vermeidet Abschreibfehler. Für Geräte ohne geeignete Verwaltungsschnittstelle bleibt eine Kontrolle vor Ort notwendig.
Eine einfache Tabelle kann mit folgenden Spalten beginnen: Geräte-ID, Kategorie, Modell, Seriennummer, Standort, Betriebssystem oder Firmware, Verantwortliche, Supportende, geschäftliche Kritikalität, bekannte Abhängigkeiten und empfohlene Massnahme. Fehlende Angaben sollten sichtbar als offen gekennzeichnet werden, statt Vermutungen einzutragen.
Wichtig ist die anschliessende Lückenanalyse. Dabei wird gezielt nach nicht dokumentierten Testservern, alten Backup-Systemen, stillgelegten, aber weiterhin verbundenen Geräten und extern bereitgestellten Komponenten gesucht. Solche Systeme können unbemerkt Sicherheits- und Betriebsrisiken verursachen.
Das Inventar ist kein einmaliges Tabellenprojekt. Es muss bei Änderungen aktualisiert werden und als gemeinsame Datengrundlage für weitere Entscheidungen dienen: Welche Systeme sind zuerst zu ersetzen? Wo fehlen Wartungsverträge? Welche Komponenten begrenzen die Leistung? Und welche Abhängigkeiten müssen bei einer Migration berücksichtigt werden?
Ein vollständiger Gerätebestand allein beantwortet allerdings noch nicht, wie gross die nächste Servergeneration dimensioniert werden muss. Dafür sind historische Messwerte über tatsächliche Last und Ressourcenverbrauch erforderlich.
Wie planen Sie Serverkapazität mit 6 Messwerten statt Bauchgefühl?
Serverkapazität lässt sich fundierter planen, wenn sechs Messgrössen systematisch ausgewertet werden: CPU-Auslastung, RAM-Nutzung, Speicherbelegung und Wachstum, Storage-I/O-Latenz, Netzwerkauslastung sowie gleichzeitig aktive Nutzer oder Sessions. Entscheidend ist, Durchschnittswerte und Lastspitzen gemeinsam zu beurteilen, historische Entwicklungen zu berücksichtigen und Reserven anhand konkreter Anwendungen festzulegen.
Für eine aussagekräftige Planung sollten Messwerte aus normalen Betriebszeiten und wiederkehrenden Spitzenphasen vorliegen. Monatsabschlüsse, saisonale Produktion, Datenimporte, Backups und Wartungsaufgaben können deutlich höhere Last verursachen als der alltägliche Betrieb.
| Messgrösse | Was wird beurteilt? | Typische Datenquelle |
|---|---|---|
| CPU-Auslastung | Durchschnitt, wiederkehrende Peaks und verfügbare Reserven | Hypervisor-Monitoring, Betriebssystemzähler |
| RAM-Nutzung | Tatsächlicher Bedarf, Speicherdruck und Auslagerung | Betriebssystem, Virtualisierungsplattform |
| Speicherbelegung und Wachstum | Belegter Platz, freier Speicher und zeitliche Entwicklung | Storage-Management, Dateisystemberichte |
| Storage-I/O-Latenz | Antwortzeiten für Lese- und Schreiboperationen | Storage-Monitoring, Performance-Counter |
| Netzwerkauslastung | Durchsatz, Spitzen, Fehler und mögliche Engpässe | Switch-Monitoring, Netzwerkadapterstatistiken |
| Gleichzeitige Nutzer oder Sessions | Parallele Nutzung und Bezug zur Anwendungsleistung | Anwendungsmonitoring, Session-Logs |
Die Messgrössen sollten zeitlich miteinander korreliert werden. Hohe CPU-Last allein bedeutet nicht zwangsläufig eine Überlastung; entscheidend ist, ob sie mit längeren Antwortzeiten oder anderen betrieblichen Einschränkungen einhergeht.
Lastspitzen müssen ausdrücklich eingeplant werden. Ein System mit niedriger durchschnittlicher Auslastung kann zum Engpass werden, wenn an geschäftskritischen Tagen regelmässig Kapazitätsgrenzen erreicht werden. Gleichzeitig ist nicht jede kurze Spitze ein Grund für neue Hardware.
Für die Prognose werden idealerweise vorhandene Messreihen über zwölf bis vierundzwanzig Monate ausgewertet. Daraus lassen sich wiederkehrende saisonale Muster, Ressourcenwachstum und Veränderungen im Nutzungsverhalten erkennen. Fehlen historische Daten, beginnt die Planung mit einer ausreichend repräsentativen Messperiode; längere Prognosen bleiben entsprechend unsicher.
Die erwartete Entwicklung wird anschliessend auf den Planungshorizont übertragen und um eine begründete Reserve ergänzt. Ein universeller Wachstumszuschlag ist wenig hilfreich: Eine stabile Fachanwendung benötigt andere Reserven als eine Plattform mit geplanten zusätzlichen Nutzern oder Datenbeständen.
Für hochverfügbare Systeme muss zudem die Last berücksichtigt werden, die verbleibende Komponenten nach einem Ausfall übernehmen sollen. Eine Kapazität, die nur im Normalbetrieb ausreicht, ist für redundante Architekturen unzureichend.
Diese Daten ermöglichen eine begründete Dimensionierung. Für geschäftskritische Anwendungen reicht reine Leistungsreserve jedoch nicht aus: Die Infrastruktur muss auch bei Komponentenfehlern oder während Wartungsarbeiten die vereinbarten Verfügbarkeitsziele erfüllen.
Das ist vor der Verfügbarkeitsplanung entscheidend
- Ein dokumentiertes Inventar zeigt, welche Komponenten und Abhängigkeiten im Fehlerfall betroffen wären.
- Gemessene Spitzenlasten bestimmen, wie viel Kapazität beim Ausfall eines Systems auf verbleibenden Komponenten verfügbar sein muss.
- Standardisierte Plattformen und geprüfte Wiederherstellungswege sind ebenso relevant wie die Anzahl redundanter Server.
Wie dimensionieren Sie Serverinfrastruktur, wenn 99,9% Verfügbarkeit gefordert wird?
Für 99,9 % Verfügbarkeit muss eine Serverinfrastruktur so dimensioniert werden, dass einzelne definierte Störungen nicht zwangsläufig zum Ausfall geschäftskritischer Dienste führen. Dafür sind ausreichende Leistungsreserven, passende Redundanz, überwachte Komponenten und getestete Wiederherstellungsverfahren erforderlich. Massgeblich ist die Verfügbarkeit des gesamten Dienstes, nicht nur die Zuverlässigkeit eines einzelnen Servers.
99,9 % ≈ 8,76 Stunden
Bei einem Bezugszeitraum von 365 Tagen entsprechen 99,9 % Verfügbarkeit rechnerisch rund 8 Stunden und 46 Minuten zulässiger Nichtverfügbarkeit pro Jahr. Die tatsächliche Bewertung hängt davon ab, welche Betriebszeiten, Ausfälle und Wartungsfenster in der Verfügbarkeitsdefinition berücksichtigt werden.
Rechnerische Einordnung des vorgegebenen Verfügbarkeitsziels.
Zuerst muss festgelegt werden, für welche geschäftlichen Dienste das Ziel gilt. Eine Produktionssteuerung, deren Unterbrechung unmittelbar den Betrieb beeinträchtigt, benötigt möglicherweise eine andere Architektur als ein internes Testsystem. Ebenso sind zulässige Einzelunterbrechungen und Wiederherstellungszeiten zu bestimmen.
Redundanz ist eine zentrale Voraussetzung, wenn einzelne Hardwareausfälle ohne vollständige Dienstunterbrechung abgefangen werden sollen. Ein mögliches Konzept ist N+1: Zusätzlich zur für den Normalbetrieb erforderlichen Kapazität wird ausreichende Reserve bereitgestellt, damit der Ausfall einer definierten Komponente bewältigt werden kann.
Das kann redundante Virtualisierungshosts, getrennte Netzwerkpfade, geeignete Stromversorgung und hochverfügbare Storage-Komponenten umfassen. Dabei sind gemeinsame Fehlerquellen zu vermeiden: Zwei Server bieten beispielsweise keinen ausreichenden Schutz vor einem Standortausfall, wenn beide von derselben kritischen Infrastruktur abhängig sind.
Die Architektur benötigt ausserdem Monitoring, dokumentierte Zuständigkeiten, Ersatzteil- und Supportregelungen sowie regelmässige Wiederherstellungstests. Backups schützen insbesondere vor Datenverlust und unterstützen die Wiederherstellung, ersetzen aber kein automatisches Failover.
Eine methodische Grundlage für die Priorisierung kritischer Systeme bietet die NIST-Publikation SP 800-34 zur IT-Notfallplanung. Sie behandelt unter anderem die strukturierte Notfallplanung und die Bewertung von Wiederherstellungsanforderungen. Die Veröffentlichung stammt aus dem Jahr 2010 und wurde ursprünglich für US-Bundesinformationssysteme entwickelt; sie definiert keine verbindliche Schweizer Architektur für 99,9 % Verfügbarkeit.
Neben der technischen Dimensionierung muss die Wirtschaftlichkeit berücksichtigt werden. Eine Steigerung des Verfügbarkeitsziels von 99,9 % auf 99,99 % reduziert den rechnerischen jährlichen Ausfallspielraum von rund 8,76 Stunden auf rund 52,56 Minuten. Der zusätzliche Aufwand für Redundanz, Betrieb, Tests und Wartung kann beträchtlich sein und ist nicht proportional aus den Prozentwerten ableitbar.
Für weniger kritische Anwendungen kann daher ein definiertes Wiederanlaufziel (Recovery Time Objective, RTO) wirtschaftlicher sein als eine vollständig redundante Architektur. Das zulässige Datenverlustfenster wird separat als Recovery Point Objective (RPO) festgelegt.
Die Grundlage einer belastbaren Architektur entsteht aus dem Zusammenspiel von Inventar, Kapazitätsmessung, Storage-Zustand, standardisiertem Betrieb und getesteter Wiederherstellung. Erst diese Gesamtsicht erlaubt eine seriöse Bewertung, ob die gewählte Infrastruktur das angestrebte Niveau zuverlässig unterstützen kann.
Als nächster Schritt empfiehlt sich eine anwendungsbezogene Entscheidungsvorlage: kritische Dienste identifizieren, Verfügbarkeitsziele und zulässige Wiederherstellungszeiten festhalten, vorhandene Messdaten prüfen und anschliessend gezielt Modernisierungsmassnahmen priorisieren. So entsteht eine On-Premise-Strategie, die Betriebssicherheit verbessert, ohne eine Cloud-Migration vorauszusetzen.
Müssen Schweizer Unternehmen personenbezogene Daten grundsätzlich auf eigenen Servern speichern?
Nein. Das Schweizer Datenschutzrecht schreibt keinen allgemeinen Vorrang lokaler Infrastruktur vor. Entscheidend sind die gesetzlichen Anforderungen an die konkrete Datenbearbeitung. Auch Cloud-Dienste können geeignet sein, sofern unter anderem Verantwortlichkeiten, Vertragsbedingungen, technische und organisatorische Schutzmassnahmen sowie gegebenenfalls die Anforderungen an Auslandbekanntgaben eingehalten werden.
Kann eine On-Premise-Umgebung ohne eigenes grosses IT-Team betrieben werden?
Ja, sofern die Architektur auf die verfügbaren personellen Ressourcen abgestimmt ist. Standardisierte Plattformen, nachvollziehbare Dokumentation, geeignete Supportverträge und externe Betriebsunterstützung können den Aufwand reduzieren. Kritische Tätigkeiten dürfen jedoch nicht ausschliesslich vom Wissen einer einzelnen Person abhängen.
Ist eine hybride Infrastruktur sinnvoller als eine vollständige Cloud-Migration?
Eine hybride Architektur kann sinnvoll sein, wenn lokale Anwendungen besondere Latenz- oder Betriebsanforderungen haben, während andere Dienste von flexiblen Cloud-Ressourcen profitieren. Sie schafft allerdings zusätzliche Anforderungen an Netzwerkverbindungen, Identitätsverwaltung, Monitoring, Datenschutz und Wiederherstellungsverfahren. Der Mehrwert muss für jede Anwendung separat beurteilt werden.
Wie lässt sich der Erfolg einer On-Premise-Modernisierung überprüfen?
Vor und nach der Modernisierung sollten vergleichbare Kennzahlen erhoben werden: Anwendungsantwortzeiten, Storage-Latenzen, Ressourcenreserven, ungeplante Ausfälle, Dauer von Wartungsarbeiten und erfolgreiche Wiederherstellungstests. Ergänzend zeigen Betriebsstunden und laufende Kosten, ob die neue Umgebung tatsächlich wartbarer und wirtschaftlicher geworden ist.
Welche Risiken bleiben auch nach einer Hardwaremodernisierung bestehen?
Neue Hardware beseitigt weder unzureichende Datensicherungen noch fehlerhafte Zugriffsrechte, unklare Verantwortlichkeiten oder gemeinsame Ausfallpunkte. Auch Softwarekompatibilität, Sicherheitsupdates und Wiederherstellungsverfahren müssen berücksichtigt werden. Eine Modernisierung ist erst dann betrieblich belastbar, wenn technische und organisatorische Schutzmassnahmen gemeinsam geprüft wurden.