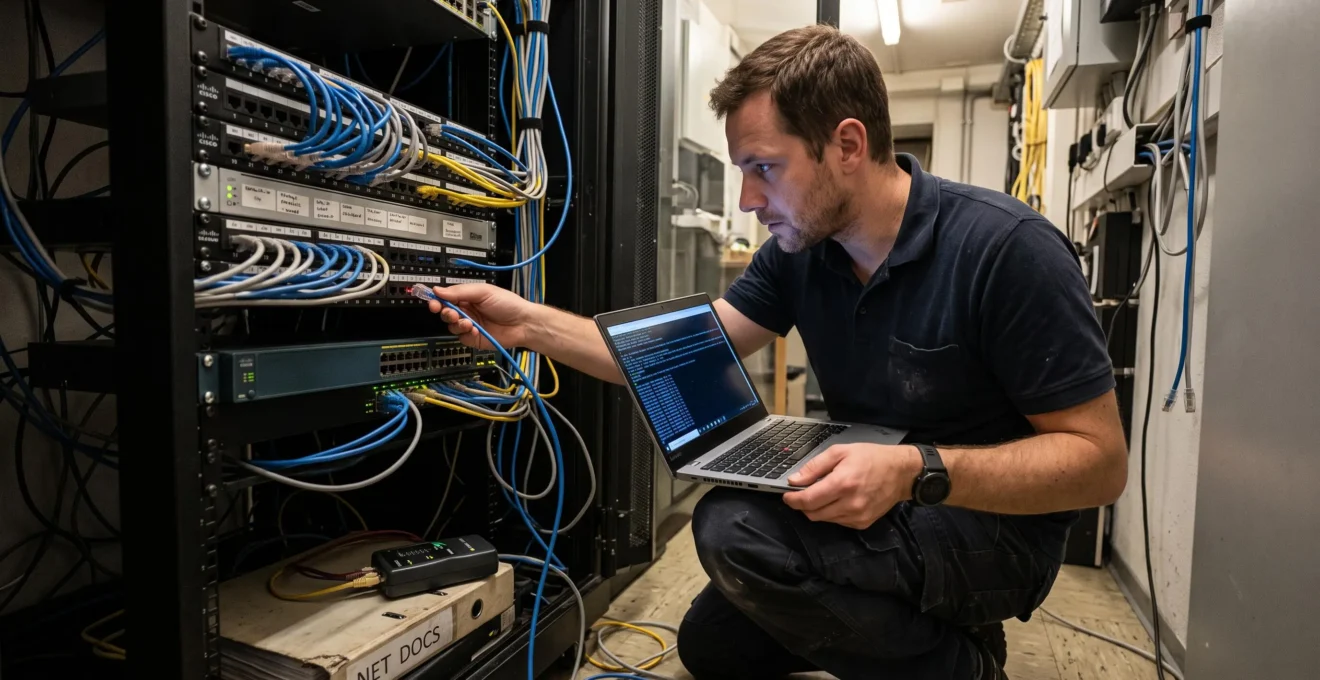
Die Internetleitung liefert ausreichend Bandbreite, trotzdem öffnen sich Dateien verzögert, Videokonferenzen ruckeln und das ERP reagiert träge. In solchen Situationen liegt der Engpass nicht zwangsläufig beim Internetanbieter. Häufig muss die Ursache innerhalb des Unternehmens gesucht werden: bei WLAN-Verbindungen, Switch-Ports, Verkabelung, Servern oder Anwendungen.
Entscheidend ist, den Datenweg zu verstehen. Eine Verbindung zu einem lokalen Fileserver beansprucht andere Komponenten als ein Zugriff auf einen Cloud-Dienst. Werden beide Vorgänge als «langsames Internet» bezeichnet, kann die Fehlersuche bereits in die falsche Richtung laufen.
Für IT-Verantwortliche in Schweizer KMU ist deshalb eine reproduzierbare Diagnose wichtiger als der vorschnelle Austausch von Hardware. Mit einfachen Messungen lassen sich Engpässe eingrenzen, Risiken durch fehlerhafte Netzwerktrennung erkennen und Investitionen anhand tatsächlicher Auslastung planen. Auch Wartungsfenster, Wiederherstellungsprozesse und Kapazitätsreserven gehören dazu: Ein leistungsfähiges Netzwerk muss nicht nur schnell sein, sondern bei Störungen und Unternehmenswachstum beherrschbar bleiben.
Das Wichtigste zur Netzwerkperformance
- Ein schneller Internetanschluss behebt keine Engpässe bei lokalen Switches, WLAN-Verbindungen, Servern oder Netzwerkkabeln.
- Fünf gezielte Tests helfen, Probleme einzugrenzen, bevor neue Hardware beschafft wird.
- WLAN-Planung, VLAN-Trennung, kontrollierte Updates und getestete Wiederherstellungsprozesse sichern den langfristigen Betrieb.
- Warum ein schnellerer Internetanschluss Ihr internes Problem nicht löst
- Wie finden Sie Netzwerkengpässe mit 5 Tests, bevor Sie neue Hardware kaufen?
- WLAN-Mesh oder professionelle Access Points: Was passt bei 800 m² Bürofläche?
- Der VLAN-Fehler, der Gäste ins Firmennetz bringt, ohne dass es jemand merkt
- Wann sollten Sie Switch- und Server-Updates machen, ohne den Betrieb zu stören?
- Wie planen Sie Serverkapazität mit 6 Messwerten statt Bauchgefühl?
- Der Single-Region-Fehler, der aus 10 Minuten Störung 8 Stunden Ausfall macht
- Was macht eine moderne IT-Infrastruktur aus, wenn Ihr Unternehmen in 12 Monaten stark wächst?
Warum ein schnellerer Internetanschluss Ihr internes Problem nicht löst
Ein Internetanschluss begrenzt nur den Verkehr, der tatsächlich über diese Verbindung läuft. Wenn lokale Dateien langsam übertragen werden, Anwendungen auf internen Servern verzögert reagieren oder WLAN-Geräte Paketverluste verursachen, hilft zusätzliche Internetbandbreite nicht. Zuerst muss geklärt werden, auf welchem Abschnitt des Datenwegs die Verzögerung entsteht.
Die Internetgeschwindigkeit wird meist in Mbit/s oder Gbit/s angegeben. Für die wahrgenommene Geschwindigkeit einer Anwendung zählen jedoch weitere Faktoren: Latenz, Jitter, Paketverluste und die Geschwindigkeit der beteiligten Endgeräte.
Ein Arbeitsplatz kann beispielsweise über einen schnellen Glasfaseranschluss verfügen, während sein Ethernet-Port wegen eines Kabelproblems nur mit 100 Mbit/s statt der vorgesehenen höheren Geschwindigkeit synchronisiert. Ebenso kann ein überlasteter WLAN-Kanal Datenübertragungen ausbremsen, obwohl der Internetrouter ausreichend Kapazität besitzt.
Der erste Schritt ist die Unterscheidung zwischen internem und externem Datenverkehr. Dazu werden vergleichbare Tests mit einem lokalen Ziel und mit einem externen Dienst durchgeführt.
| Beobachtung | Möglicher Fehlerbereich | Sinnvoller Vergleich |
|---|---|---|
| Lokale Netzlaufwerke sind langsam | LAN, Server, Storage oder Client | Lokale Dateiübertragung und Serverlast |
| Nur WLAN-Geräte sind betroffen | Funkabdeckung, Interferenzen oder Access Point | Dasselbe Gerät über Ethernet testen |
| Nur Cloud-Dienste reagieren langsam | Internetstrecke, DNS, Proxy oder Cloud-Dienst | Interne und externe Ziele vergleichen |
| Mehrere Dienste sind gleichzeitig betroffen | Gemeinsame Netzwerkkomponente | Gateway, Switches und zentrale Dienste prüfen |
Bei Microsoft 365, Outlook und SharePoint muss zusätzlich der tatsächliche Betriebsmodus berücksichtigt werden. SharePoint Online nutzt einen externen Dienst, während lokale Dateifreigaben oder intern betriebene Anwendungen innerhalb des Firmennetzes erreichbar sein können. Die Produktbezeichnung allein sagt daher nicht zuverlässig aus, welcher Netzwerkpfad verwendet wird.
In Schweizer Bürogebäuden mit älterer Infrastruktur lohnt sich ausserdem eine Prüfung der strukturierten Verkabelung. Kabelkategorie, Zustand, Anschlussqualität und tatsächlich ausgehandelte Linkgeschwindigkeit können die Leistung begrenzen. Aus dem Gebäudealter allein lässt sich allerdings kein Kabelengpass ableiten.
Für die Geschäftsleitung lautet die entscheidende Frage deshalb nicht «Wie viel zusätzliche Bandbreite brauchen wir?», sondern «Welche gemessene Komponente begrenzt unsere Arbeitsabläufe?». Erst diese Antwort macht eine Investitionsentscheidung belastbar.
Wie finden Sie Netzwerkengpässe mit 5 Tests, bevor Sie neue Hardware kaufen?
Mit fünf Tests lässt sich ein Netzwerkproblem ohne sofortige Hardwareinvestition eingrenzen: Latenz zum Gateway messen, zentralen Server prüfen, Dateiübertragungen testen, WLAN-Funkqualität untersuchen und Messungen zu verschiedenen Zeiten vergleichen. Entscheidend sind mehrere Messpunkte und wiederholbare Ergebnisse. Ein einzelner Speedtest reicht für eine belastbare Diagnose nicht aus.
Für die Untersuchung sollten betroffene Geräte, Uhrzeit, Netzwerksegment, Verbindungstyp und konkretes Symptom festgehalten werden. Ein kabelgebundener Referenzarbeitsplatz hilft, Funkprobleme von allgemeinen Netzwerkproblemen zu trennen.
- Gateway-Latenz messen: Mit
pingdas lokale Standardgateway prüfen. Hohe oder stark schwankende Antwortzeiten können auf Probleme am Client, im WLAN oder auf dem lokalen Weg zum Gateway hinweisen. Eine niedrige Antwortzeit beweist hingegen nicht, dass alle Datenpfade fehlerfrei sind. - Zentralen Server prüfen: Wiederholte Ping-Messungen zu einem internen Server vergleichen. Abweichungen gegenüber dem Gateway können Hinweise auf weitere Netzwerksegmente oder den Zielserver liefern. ICMP-Priorisierung und Firewalls müssen bei der Interpretation berücksichtigt werden.
- Dateiübertragung messen: Eine repräsentative Datei zwischen Arbeitsplatz und Netzfreigabe übertragen. Das Ergebnis in MB/s protokollieren. Für eine isolierte Durchsatzmessung kann ergänzend
iperf3zwischen kontrollierten Endpunkten eingesetzt werden. - WLAN am Arbeitsplatz untersuchen: Signalstärke, Signal-Rausch-Verhältnis, Kanalbelegung und mögliche Interferenzen erfassen. Messungen an unterschiedlichen Arbeitsplätzen helfen, lokale Funkprobleme zu erkennen.
- Zeitpunkte und Standorte vergleichen: Dieselben Tests während normaler Nutzung und bei hoher Last wiederholen. Mehrere Messfenster zeigen, ob Leistungseinbrüche mit bestimmten Nutzungszeiten oder Netzwerkbereichen zusammenhängen.
Die Ergebnisse werden gemeinsam interpretiert. Gute Gateway-Werte bei langsamer Dateifreigabe lenken die Untersuchung eher auf den weiteren Datenweg, das Storage-System oder die Anwendung. Schlechte WLAN-Werte bei gleichzeitig stabiler Ethernet-Verbindung sprechen dagegen für eine genauere Funkanalyse.
Auch Switch-Port-Statistiken sind hilfreich. CRC-Fehler, verworfene Pakete, Duplex- oder Geschwindigkeitsprobleme können auf physische Störungen oder Kapazitätsgrenzen hinweisen. Solche Zähler sollten über einen definierten Zeitraum beobachtet und nicht isoliert bewertet werden.
Checkliste: Netzwerkengpass vor dem Hardwarekauf eingrenzen
- Betroffene Arbeitsplätze und Anwendungen erfassen; Ergebnis: eine Liste mit Gerät, Netzwerksegment und Fehlerbeschreibung.
- Gateway und Server wiederholt anpingen; Ergebnis: ein Messprotokoll mit Uhrzeit, Latenz und Paketverlusten.
- Lokale Dateiübertragung oder iperf3-Test durchführen; Ergebnis: dokumentierter Durchsatz mit Angabe des Testwegs.
- WLAN-Qualität und Switch-Port-Statistiken kontrollieren; Ergebnis: eine Übersicht auffälliger Funkbereiche und Ports.
- Messungen zu unterschiedlichen Lastzeiten wiederholen; Ergebnis: eine priorisierte Hypothesenliste mit nächstem Prüfschritt.
Besonders bei sporadischen Störungen ist die Messdauer entscheidend. Wenn ein Problem nur montags beim Arbeitsbeginn auftritt, liefert ein kurzer Test am Freitagnachmittag möglicherweise keinerlei Hinweis auf die tatsächliche Ursache.
WLAN-Mesh oder professionelle Access Points: Was passt bei 800 m² Bürofläche?
Für 800 m² Bürofläche ist ein professionell verwaltetes Access-Point-System mit möglichst kabelgebundenem Anschluss häufig die besser planbare Lösung. Ein Mesh-System kann bei schwieriger Verkabelung sinnvoll sein, benötigt aber ebenfalls sorgfältige Funkplanung. Ausschlaggebend sind Wände, Etagen, Nutzerzahl, Endgeräte, Anwendungen und die tatsächliche Funkbelastung.
Ein Mesh-System erweitert die WLAN-Versorgung über mehrere miteinander verbundene Knoten. Nutzen diese Knoten Funkverbindungen als Backhaul, teilen sich je nach Architektur und Funkressourcen Client-Verkehr und Verbindung zwischen den Knoten verfügbare Kapazität.
Professionelle Access Points werden dagegen häufig über Ethernet und PoE angeschlossen. Eine zentrale Verwaltung ermöglicht koordinierte Konfiguration, Überwachung und Kanalplanung. Das macht eine solche Architektur für grössere Büroflächen oft einfacher kontrollierbar, garantiert aber noch keine gute Funkabdeckung.
Gerade Betonwände, Stahlträger, mehrere Stockwerke und verwinkelte Grundrisse verändern die Ausbreitung der Funksignale erheblich. Ein offenes Büro mit 800 m² stellt andere Anforderungen als dieselbe Fläche mit zahlreichen Einzelräumen.
Die technische Cisco-Dokumentation zur WLAN-Funkvermessung unterscheidet passive, aktive und prädiktive Vermessungen. Dabei werden unter anderem Abdeckung, Signalqualität, Interferenzen und Anforderungen gleichzeitig verbundener Geräte berücksichtigt.
Eine wichtige Erkenntnis: Mehr Access Points bedeuten nicht automatisch besseres WLAN. Ungünstige Kanalbelegung, überlappende Funkzellen und gegenseitige Störungen können den tatsächlich nutzbaren Durchsatz verschlechtern.
| Kriterium | WLAN-Mesh | Verwaltete Access Points |
|---|---|---|
| Netzwerkanbindung | Je nach System drahtlos oder kabelgebunden | Typischerweise Ethernet mit PoE |
| Zentrale Verwaltung | Abhängig vom Produkt | Meist umfangreiche Verwaltungsfunktionen |
| Funkkapazität | Abhängig von Backhaul und Funkplanung | Bei kabelgebundenem Uplink besser vom Funk-Backhaul entkoppelt |
| Gastnetz und VLANs | Funktionsumfang prüfen | Häufig differenzierte Segmentierung möglich |
| Erweiterbarkeit | Abhängig von System und Topologie | Planbare Ergänzung weiterer Access Points |
Eine pauschale Aussage, wie viele Access Points für 800 m² benötigt werden, wäre ohne Gebäudeplan und Messdaten unzuverlässig. Für eine erste Planung werden Raumaufteilung, Nutzerverteilung, Endgeräte, Anwendungen und mögliche Montagepositionen erfasst. Anschliessend wird die Auslegung durch eine Funkvermessung überprüft.
Ist die Funkversorgung geplant, folgt ein ebenso wichtiger Schritt: Die verschiedenen Nutzergruppen müssen logisch voneinander getrennt werden. Gute WLAN-Abdeckung darf nicht zu unkontrolliertem Zugriff auf interne Systeme führen.
Der VLAN-Fehler, der Gäste ins Firmennetz bringt, ohne dass es jemand merkt
Ein Gäste-WLAN kann trotz eigenem Namen und Passwort Zugriff auf interne Systeme ermöglichen, wenn VLAN-Zuordnung, Routing oder Firewall-Regeln falsch eingerichtet sind. Eine separate SSID allein garantiert keine Netzwerktrennung. Unternehmen müssen deshalb überprüfen, welche internen Dienste ein Gastgerät tatsächlich erreichen kann und ob unerwünschte Verbindungen zuverlässig blockiert werden.
Ein VLAN trennt Geräte auf einer gemeinsamen physischen Infrastruktur in logische Netzwerkbereiche. Im Unternehmen können beispielsweise Arbeitsplätze, Server, Drucker, Verwaltungssysteme und Gäste unterschiedlichen VLANs zugeordnet werden.
Diese Trennung schützt jedoch nur dann wie vorgesehen, wenn die beteiligten Switches, Access Points und Routing- beziehungsweise Firewall-Komponenten konsistent konfiguriert sind.
Typische Fehler entstehen durch eine falsch zugeordnete WLAN-SSID, einen Switch-Port im falschen VLAN oder zu weit gefasste Regeln zwischen den Netzsegmenten. Auch ein vermeintlich isoliertes Gastnetz kann durch unbeabsichtigte Routing-Freigaben Zugriff auf interne Adressen erhalten.
Für die Kontrolle wird ein autorisiertes Testgerät mit dem Gäste-WLAN verbunden. Anschliessend wird überprüft, ob interne Fileserver, Drucker, Kameras, administrative Oberflächen oder andere geschützte Dienste erreichbar sind. Die Tests sollten sowohl erlaubte Internetverbindungen als auch ausdrücklich unerwünschte interne Verbindungen erfassen.
Ein fehlgeschlagener Ping ist dabei kein ausreichender Nachweis für Isolation, weil ICMP auf Zielsystemen blockiert sein kann. Aussagekräftiger sind kontrollierte Verbindungsversuche zu definierten Testdiensten sowie die Prüfung der zugehörigen Firewall-Protokolle.
Für Schweizer KMU ist die Trennung auch datenschutzrelevant. Werden Personendaten durch eine Fehlkonfiguration unzureichend geschützt, können Anforderungen des Schweizer Datenschutzgesetzes betroffen sein. Der Eidgenössische Datenschutz- und Öffentlichkeitsbeauftragte erläutert in seinen Informationssicherheits-Leitfäden des EDÖB technische und organisatorische Schutzmassnahmen sowie Voraussetzungen im Zusammenhang mit Datensicherheitsverletzungen.
Nicht jede Fehlkonfiguration löst automatisch eine Meldepflicht aus. Entscheidend sind die konkreten Umstände und gesetzlichen Voraussetzungen. Technisch sollte der Test jedoch nicht erst nach einem Vorfall erfolgen, sondern nach jeder relevanten Änderung an Access Points, Switches oder Firewall-Regeln wiederholt werden.
Eine dokumentierte Netzsegmentierung reduziert zudem den Aufwand bei späteren Erweiterungen: Neue Geräte und WLAN-Zugänge können eindeutig zugeordnet werden, ohne bestehende Sicherheitsgrenzen unbemerkt aufzuheben.
Wann sollten Sie Switch- und Server-Updates machen, ohne den Betrieb zu stören?
Switch- und Server-Updates gehören in geplante Wartungsfenster, deren Zeitpunkt von den tatsächlichen Geschäftsprozessen abhängt. Kritische Komponenten sollten möglichst gestaffelt aktualisiert werden. Vor jedem Eingriff braucht es eine Sicherung der relevanten Konfigurationen, eine Prüfung der Abhängigkeiten, einen Rückfallplan und klare Kriterien für den erfolgreichen Abschluss.
Ein Wochenende ist nicht automatisch der beste Wartungszeitpunkt. In Unternehmen mit Schichtbetrieb, international genutzten Anwendungen oder automatisierten Nachtverarbeitungen kann auch ausserhalb der Bürozeiten produktive Last anfallen. Ebenso kann ein Monatsende für Finanz- und Abrechnungssysteme besonders kritisch sein.
Die Wartungsplanung sollte deshalb aus den tatsächlichen Nutzungsdaten und Geschäftsanforderungen entstehen.
Unterschiedliche Updates erfordern unterschiedliche Verfahren:
- Switch-Firmware: Kann Ports, Routing, Redundanzprotokolle oder Managementfunktionen vorübergehend beeinträchtigen. Herstellerhinweise und Abhängigkeiten zwischen Geräten sind zu berücksichtigen.
- Serverbetriebssystem und Netzwerk-Stack: Können Neustarts oder Dienstunterbrechungen verursachen und sollten hinsichtlich Anwendungskompatibilität geprüft werden.
- Kritische Sicherheitsupdates: Erfordern eine risikobasierte Priorisierung. Eine längere Verschiebung kann gefährlicher sein als eine kontrollierte kurzfristige Wartung.
- Routine-Updates: Können je nach Produkt und Architektur teilweise ohne Unterbrechung erfolgen. Diese Fähigkeit muss jedoch für die konkrete Umgebung bestätigt werden.
Vor einem Firmware-Update sollten Konfiguration und installierte Version dokumentiert sein. Entscheidend ist auch die Frage, ob ein Downgrade technisch unterstützt wird und wie sich der vorherige Zustand tatsächlich wiederherstellen lässt.
Bei Servern reicht ein vorhandenes Backup allein nicht aus. Der Wiederherstellungsvorgang muss zur betroffenen Anwendung, den Abhängigkeiten und den vorgesehenen Ausfallzeiten passen.
Ein kontrollierter Ablauf umfasst die Freigabe des Wartungsfensters, die Vorprüfung, die Durchführung, anschliessende Funktionstests und eine dokumentierte Betriebsübergabe. Bei kritischen Systemen sollte während des Eingriffs geklärt sein, wer im Fehlerfall Entscheidungen trifft.
Updates sind ausserdem Teil der Performancepflege. Veraltete Firmware kann bekannte Stabilitäts- oder Kompatibilitätsprobleme enthalten. Ob eine Aktualisierung ein konkretes Leistungsproblem behebt, muss anhand der Herstellerdokumentation und anschliessender Messungen geprüft werden.
Damit Wartungsentscheidungen nicht nur reaktiv erfolgen, sollten gleichzeitig die verfügbaren Kapazitätsreserven überwacht werden. Denn auch eine vollständig aktualisierte Infrastruktur kann unter zunehmender Last an ihre Grenzen geraten.
Wie planen Sie Serverkapazität mit 6 Messwerten statt Bauchgefühl?
Serverkapazität lässt sich mit sechs Messwerten planen: CPU-Auslastung, RAM-Nutzung, Datenträgerleistung, Netzwerkdurchsatz, Speicherplatzwachstum und Anwendungsantwortzeiten. Die Werte sollten über mehrere Wochen mit einem vergleichbaren Messintervall erfasst werden. Erst wiederkehrende Engpassmuster und Wachstumstrends zeigen, wann zusätzliche Ressourcen oder eine technische Optimierung notwendig werden.
Eine Momentaufnahme kann täuschen. Ein Server mit hoher CPU-Auslastung während einer geplanten Verarbeitung muss nicht zwingend unterdimensioniert sein. Problematisch wird die Auslastung vor allem dann, wenn gleichzeitig kritische Anwendungen ihre geforderten Antwortzeiten nicht mehr erreichen.
Die sechs Kennzahlen decken unterschiedliche Engpassarten ab:
| Messwert | Worauf achten? | Mögliche Massnahme |
|---|---|---|
| CPU-Auslastung | Dauerlast, Spitzen, betroffene Prozesse | Prozesse optimieren oder Rechenkapazität prüfen |
| RAM-Nutzung | Verfügbarer Speicher, Paging, Speicherengpässe | Speichernutzung analysieren oder RAM erweitern |
| Datenträger-I/O | IOPS, Durchsatz, Latenz und Warteschlangen | Storage-Konfiguration und Anwendungen untersuchen |
| Netzwerkdurchsatz | Übertragungsspitzen, Fehler und Schnittstellenlast | Netzwerkpfad und Schnittstellenkapazität prüfen |
| Speicherplatzwachstum | Belegungsgrad und Wachstum pro Zeitraum | Bereinigung, Archivierung oder Erweiterung planen |
| Anwendungsantwortzeiten | Reaktionszeiten kritischer Geschäftsprozesse | Technische Messwerte mit Anwendungstraces abgleichen |
Die Microsoft-Dokumentation zur Leistungsanalyse mit Performance Monitor beschreibt die Erfassung von Prozessor-, Arbeitsspeicher-, Datenträger- und Netzwerkindikatoren. Bei sporadischen Problemen sind länger laufende Messungen hilfreich, um wiederkehrende Lastmuster zu erkennen.
Für unterstützte Windows-Server-Umgebungen nennt Microsoft eine dauerhaft über 85 Prozent liegende CPU-Auslastung als möglichen Engpasshinweis. Dieser Wert ist kein universeller Grenzwert. Die Bedeutung hängt von Workload, Laufzeitverhalten und Anwendungsanforderungen ab.
Auch Anwendungssymptome dürfen nicht vorschnell einzelnen Ressourcen zugeordnet werden. Ein langsames ERP kann durch Datenbankabfragen, Speicher-I/O, Netzwerkverbindungen oder andere Ursachen ausgebremst werden. Verzögerte Anmeldungen können ebenfalls unterschiedliche Gründe haben, darunter Probleme mit Authentifizierungsdiensten.
Für die Kapazitätsplanung zählt der Trend. Werden Messwerte über mehrere Wochen erfasst und mit Nutzerzahlen, Geschäftsprozessen sowie geplanten Veränderungen verknüpft, können Schwellenwerte für zusätzliche Prüfungen definiert werden.
Ein Beispiel als hypothetisches Planungsszenario: Steigt die Speicherbelegung über mehrere Messperioden kontinuierlich, kann das verbleibende Kapazitätsfenster anhand dieses Trends abgeschätzt werden. Die Berechnung muss Veränderungen durch Archivierung, Datenmigration und neue Anwendungen berücksichtigen.
Solche Messreihen erleichtern auch Budgetgespräche. Statt eine pauschale Servererweiterung zu beantragen, lässt sich zeigen, welche Ressource sich einem betrieblich relevanten Grenzwert nähert und welche Anwendung dadurch gefährdet sein könnte.
Kapazitätsreserven lösen allerdings nicht jedes Verfügbarkeitsproblem. Selbst ein wenig ausgelasteter Server kann den gesamten Betrieb unterbrechen, wenn er ohne Ersatzweg oder funktionierenden Wiederherstellungsprozess ausfällt.
Der Single-Region-Fehler, der aus 10 Minuten Störung 8 Stunden Ausfall macht
Eine kurze technische Störung kann einen deutlich längeren Betriebsunterbruch verursachen, wenn kritische Systeme nur an einem Standort oder in einer Cloud-Region betrieben werden und keine funktionierende Ausweichmöglichkeit existiert. Die eigentliche Ausfallzeit entsteht dann durch Erkennung, Diagnose, Wiederherstellung und Neustart abhängiger Dienste. Die Dauer lässt sich ohne konkretes Szenario nicht pauschal beziffern.
Ein Single Point of Failure ist eine Komponente, deren Ausfall einen kritischen Prozess vollständig unterbrechen kann. Das kann ein zentraler Switch, ein einzelner Server, ein Storage-System, ein Internetzugang oder ein Standort sein.
Bei Cloud-Anwendungen kann eine einzelne Region dieselbe Rolle übernehmen, wenn sämtliche erforderlichen Dienste dort konzentriert sind. Mehrere virtuelle Server innerhalb derselben Region beseitigen nicht automatisch alle gemeinsamen Ausfallrisiken.
Die im Titel genannten zehn Minuten und acht Stunden verdeutlichen ein hypothetisches Szenario, keine statistisch nachgewiesene durchschnittliche Ausfalldauer.
Hypothetisches Szenario: Kurze Störung, langer Wiederanlauf
Ein Unternehmen betreibt seine zentrale Anwendung ausschliesslich in einer Cloud-Region. Eine kurze Störung unterbricht die Erreichbarkeit. Nach Ende des ursprünglichen Ereignisses startet die Anwendung nicht vollständig, weil abhängige Komponenten geprüft und Daten aus Sicherungen wiederhergestellt werden müssen.
Die technische Ursache besteht möglicherweise nur kurz, während Diagnose, Wiederherstellung und abschliessende Anwendungstests mehrere Stunden beanspruchen. Acht Stunden sind in diesem Beispiel eine angenommene Dauer und kein allgemein gültiger Erfahrungswert.
Die Gegenmassnahmen hängen davon ab, welche Dienste wie schnell wieder verfügbar sein müssen. Für einzelne Systeme kann eine zweite Komponente genügen. Andere Anwendungen benötigen redundante Netzwerkpfade, einen zweiten Standort oder eine geeignete Multi-Region-Architektur.
Redundanz allein ersetzt dabei keine Backups. Umgekehrt sorgt eine Datensicherung ohne vorbereitete Wiederherstellungsumgebung nicht für einen schnellen Neustart.
Besonders wichtig sind zwei Zielgrössen: Die Recovery Time Objective (RTO) beschreibt die angestrebte maximale Wiederherstellungsdauer. Die Recovery Point Objective (RPO) beschreibt den maximal akzeptierten Datenverlust in zeitlicher Hinsicht.
Das Schweizer Bundesamt für Cybersicherheit empfiehlt in seinen Empfehlungen des Bundesamts für Cybersicherheit zum IT-Grundschutz, IT-Abhängigkeiten zu erfassen, Verantwortlichkeiten festzulegen und Notfallkonzepte vorzubereiten. Auch alternative Arbeitsmöglichkeiten bei vorübergehenden Ausfällen gehören zur betrieblichen Vorsorge.
Oft übersehene Abhängigkeiten sind ein einziger IT-Verantwortlicher ohne dokumentierte Stellvertretung, ungetestete USV-Batterien und Cloud-Dienste, für die kein praktikabler Ersatzprozess existiert. Solche organisatorischen Schwachstellen können technische Redundanz teilweise wirkungslos machen.
Ein verlässlicher Betrieb entsteht daher durch eine Kombination aus Redundanz, Monitoring, getesteten Wiederherstellungen und klaren Zuständigkeiten. Diese Fähigkeiten müssen auch bei zukünftigen Erweiterungen erhalten bleiben.
Worauf es bei der nächsten IT-Ausbaustufe ankommt
- Vor zusätzlichen Standorten oder Arbeitsplätzen müssen gemeinsame Abhängigkeiten und mögliche Engpässe sichtbar sein.
- Einheitliche Standards vereinfachen Erweiterungen, Wartung und Fehlersuche.
- Kapazitätsreserven, Sicherheitsgrenzen und Wiederherstellungsprozesse müssen mit der Unternehmensgrösse mitwachsen.
Was macht eine moderne IT-Infrastruktur aus, wenn Ihr Unternehmen in 12 Monaten stark wächst?
Eine moderne IT-Infrastruktur bleibt auch bei schnellem Unternehmenswachstum überschaubar, erweiterbar und sicher betreibbar. Dafür braucht es dokumentierte Netzwerkstrukturen, standardisierte Komponenten, zentrale Benutzerverwaltung, laufendes Monitoring und überprüfte Wiederherstellungsverfahren. Zusätzliche Kapazität sollte anhand messbarer Anforderungen geplant werden, nicht allein aufgrund erwarteter Mitarbeiterzahlen.
Wächst ein Unternehmen innerhalb von zwölf Monaten deutlich, verändern sich die Anforderungen an Netzwerk, Server und Betriebsorganisation oft gleichzeitig. Mehr Mitarbeitende erzeugen zusätzliche Endgeräte und Verbindungen. Neue Büroflächen verändern die Verkabelung und WLAN-Abdeckung. Ein weiterer Standort erfordert unter Umständen neue Verbindungen, Sicherheitsregeln und zentrale Verwaltungsprozesse.
Entscheidend ist deshalb, Erweiterungen nicht isoliert zu betrachten.
| Wachstumsszenario | Technischer Schwerpunkt | Vorbereitende Prüfung |
|---|---|---|
| Mehr Mitarbeitende | WLAN-Kapazität, Benutzerverwaltung, Endgeräte und Serverlast | Nutzerzahlen mit bestehenden Leistungsdaten abgleichen |
| Grössere Bürofläche | Verkabelung, Switch-Ports, Funkabdeckung und Stromversorgung | Gebäude- und WLAN-Planung aktualisieren |
| Zusätzlicher Standort | Standortvernetzung, Zugriffsschutz und zentrale Dienste | Netzwerktopologie, Verfügbarkeit und Zuständigkeiten prüfen |
| Neue geschäftskritische Anwendung | Serverressourcen, Storage, Netzwerklatenz und Wiederherstellung | Lastprofil, Abhängigkeiten, RTO und RPO bestimmen |
Eine dokumentierte Netzwerktopologie sollte mindestens die zentralen Verbindungen, relevanten Netzwerksegmente, Routing- und Sicherheitsgrenzen sowie die kritischen Dienste nachvollziehbar abbilden. Ergänzend erleichtern einheitliche Hardwaremodelle und definierte Konfigurationsstandards die Wartung.
Zentrale Benutzerverwaltung unterstützt die kontrollierte Vergabe und Entziehung von Zugriffsrechten. Besonders bei neuen Mitarbeitenden, Standortwechseln und externen Dienstleistern reduziert ein geregelter Prozess die Gefahr uneinheitlicher Berechtigungen.
Kapazitätsreserven werden auf Basis der gemessenen CPU-, RAM-, Storage- und Netzwerkentwicklung geplant. Dabei ist auch zu prüfen, ob zusätzliche Nutzer bestehende Anwendungslizenzen, Netzwerksegmente oder Authentifizierungsdienste stärker beanspruchen.
Die Betriebsorganisation muss ebenfalls skalieren. Ein internes IT-Team kann kurze Wege und unmittelbare Systemkenntnis bieten. Ein externer IT-Partner kann ergänzende Fachkompetenz, Vertretung und geregelte Betriebsleistungen bereitstellen. Für Schweizer KMU ist nicht allein der Preis entscheidend, sondern ob Monitoring, Dokumentation, Sicherheitsmassnahmen und Wiederanlaufprozesse dauerhaft betreut werden.
Verantwortlichkeiten, Reaktionswege und Zuständigkeiten sollten dabei ausdrücklich vereinbart sein. Kritische Entscheidungen dürfen nicht allein von informellem Wissen einzelner Personen abhängen.
Die wichtigste Eigenschaft einer skalierbaren Infrastruktur ist ihre Beherrschbarkeit. Neue Geräte und Standorte sollten auf bestehende Standards aufbauen können, ohne dass jede Erweiterung eine grundlegende Neuplanung auslöst.
Als nächster Schritt bietet sich eine Bestandsaufnahme der geschäftskritischen Anwendungen, Netzwerksegmente, Kapazitätsdaten und Wiederherstellungsabhängigkeiten an. Daraus lässt sich eine priorisierte Ausbauplanung für die kommenden zwölf Monate erstellen, deren Massnahmen technisch begründet und im Betrieb überprüfbar sind.
Kann ein DNS-Problem wie ein langsames Netzwerk wirken?
Ja. Verzögerte oder fehlgeschlagene Namensauflösungen können dazu führen, dass Anwendungen langsam starten oder Dienste zeitweise nicht erreichbar erscheinen. Ein Vergleich zwischen DNS-Auflösung, direkter IP-Erreichbarkeit und eigentlicher Anwendungsantwort hilft bei der Eingrenzung. Direkte IP-Tests ersetzen jedoch nicht die vollständige Prüfung einer Anwendung.
Warum ist ein Speedtest schnell, obwohl Anwendungen langsam bleiben?
Ein Speedtest misst die Datenübertragung zu bestimmten Testservern unter den jeweiligen Testbedingungen. Er prüft nicht automatisch die Leistung eines internen Fileservers, einer Datenbank, einer WLAN-Verbindung zu jedem Arbeitsplatz oder eines geschäftlichen Cloud-Dienstes. Unterschiedliche Datenwege und Anwendungslasten können deshalb stark abweichende Ergebnisse liefern.
Wie oft sollten Netzwerk- und Servermesswerte kontrolliert werden?
Kritische Systeme sollten möglichst kontinuierlich überwacht werden. Für Kapazitätsentscheidungen sind zusätzlich regelmässige Trendanalysen über längere Zeiträume sinnvoll. Wie häufig Berichte ausgewertet werden, hängt von der Kritikalität, der Veränderungsgeschwindigkeit und den verfügbaren Betriebsressourcen ab.
Muss jedes Schweizer KMU eine zweite Cloud-Region betreiben?
Nein. Eine zweite Region ist eine mögliche Massnahme gegen bestimmte Ausfallrisiken, aber keine allgemeine Pflicht oder universell wirtschaftliche Lösung. Die Entscheidung hängt von geschäftskritischen Abhängigkeiten, Anforderungen an Wiederherstellungsdauer und Datenverlust, Architektur und Kosten ab. Auch Sicherungen, alternative Arbeitsverfahren und getestete Notfallabläufe können Bestandteil einer angemessenen Strategie sein.
Was sollte bei der Übergabe eines Firmennetzwerks an einen IT-Dienstleister dokumentiert werden?
Mindestens die Netzwerktopologie, IP-Adressbereiche, VLANs, zentrale Komponenten, Konfigurationssicherungen, kritische Anwendungen und definierten Verantwortlichkeiten. Hinzu kommen geregelte administrative Zugänge, Wartungsprozesse, Überwachungsanforderungen und Wiederherstellungsverfahren. Zugangsdaten sollten über sichere, dafür vorgesehene Verfahren übergeben werden und nicht ungeschützt in allgemeinen Dokumenten stehen.